当一个智能体在几秒钟内完成思考、检索、规划和执行,它的背后往往涉及多次模型调用、海量数据访问以及复杂的资源调度,一场围绕基础设施的演变也随之展开。在 2026 云栖大会上,英特尔携手阿里云展示了双方在智能体 AI 领域的最新进展。基于英特尔® 至强® 处理器,双方围绕云实例性能优化、AI 存储平台加速、Agentic Browser 创新应用以及千问展开合作,共同探索面向智能体时代的新一代基础设施架构。
当一个智能体在几秒钟内完成思考、检索、规划和执行,它的背后往往涉及多次模型调用、海量数据访问以及复杂的资源调度,一场围绕基础设施的演变也随之展开。在 2026 云栖大会上,英特尔携手阿里云展示了双方在智能体 AI 领域的最新进展。基于英特尔® 至强® 处理器,双方围绕云实例性能优化、AI 存储平台加速、Agentic Browser 创新应用以及千问展开合作,共同探索面向智能体时代的新一代基础设施架构。

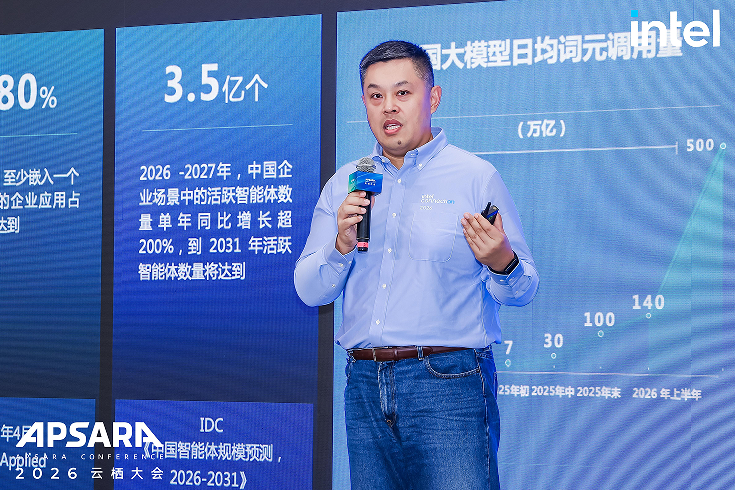
英特尔数据中心集团副总裁、中国区总经理陈葆立发表开场致辞
英特尔数据中心集团副总裁、中国区总经理陈葆立表示:「智能体 AI 时代,算力是起点,贯穿记忆、调度、执行的系统能力,是决定智能体走多远的关键。凭借强大的算力与内置加速引擎,至强正在为智能体 AI 提供更敏捷的思考、更持久的记忆、更高效的任务承载和更可靠的执行。我们希望,英特尔和阿里云的携手,既能推动 AI 速度更快,又能让 AI 规模化落地,创造真正的价值。」
在云端:从至强的芯片底层,优化智能体的真实运行环境
搭载英特尔至强 6 处理器的阿里云第九代企业级 ECS 实例 g9i,覆盖智能体全栈算力需求。针对智能体业务形态多变的特点,g9i 实现了按智能体真实工作负载形态精准供给算力,打造了涵盖专有硬件 AI 加速、QAT 硬件加速、数据全路径持久化、安全可靠的虾笼、出色的弹性能力和稳定性优化在内的 6 大技术能力。
英特尔至强 6 处理器从芯片底层激活了 g9i 的效能,提供了高密度的核心数、出色的单核性能与内存带宽,同时又在性能与能效曲线上找到了平衡点,成为承载 AI 智能体复杂工作负载的可靠支撑,帮助 g9i 性能较上代提升最高达 20%,弹性临时盘单盘吞吐最高 4GB/s,为更多的行业与客户提供了更强劲、更稳定的云计算服务 1。
在智能体 AI 加速落地的今天,硬件之外的开放软件生态也成为决定因素之一。依托开放统一的软件底座,英特尔打通不同架构之间的开发壁垒,让应用迁移和性能优化变得更加简单。通过引入基于大语言模型的 AI Agent,并结合面向专业场景的 Skill 能力,实现高效、高性能的代码原生迁移与优化。从 PyTorch、vLLM 到 SGLang,英特尔持续完善开放软件生态,为开发者提供覆盖模型开发、推理部署和应用落地的完整工具链,让 AI 应用更快速地落地。
英特尔携手阿里云终端智能,以软硬件协同加速面向海量 Agent 的轻量级云端浏览器落地
在云栖大会现场,英特尔数据中心集团副总裁、中国区总经理陈葆立和阿里云智能集团研发副总裁、终端智能计算事业部负责人张献涛出席 Agentic Browser 合作仪式。阿里云终端智能与英特尔围绕浏览器引擎优化、硬件加速及云端高密度部署展开合作,共同推动 Agentic Browser 在智能体场景中的规模化应用。

英特尔数据中心集团副总裁、中国区总经理陈葆立,阿里云智能集团研发副总裁、终端智能计算事业部负责人张献涛出席 Agentic Browser 合作仪式
针对传统浏览器在海量 Agent 并发调用时面临的高内存占用问题,双方基于官方 Chromium 技术体系,对 Blink、V8 等核心引擎进行轻量化优化,并结合英特尔至强处理器、AVX-512 指令集以及 IAA、QAT 等硬件加速器能力,降低浏览器运行时的内存与 CPU 开销。联合优化方案可减少约 30% 的内存开销。
在此基础上,阿里云依托弹性计算和高密度调度能力,将轻量级浏览器部署为面向海量 Agent 的云端执行集群,并融合 Agent 与 RPA 双引擎、Workflow 自动沉淀及多层风控机制,提升复杂网页任务的执行效率与稳定性,推动浏览器向低成本、可信赖的智能体云端执行基础设施演进。
软硬协同创新,打造适合智能体时代的存储
智能体 AI 带来的改变遍布整个 AI 系统,而存储是最先发生改变的环节之一。其中包括,块存储规模迅速增长,云盘生命周期缩短,工作负载呈现出随机、突发的特征,大量独立存储环境与多样化存储形态随之出现。顺应这一趋势,英特尔与阿里云携手开启新的探索,共同打造基于英特尔至强 6 处理器的阿里云磐久第九代服务器,为 AI 基础设施带来低时延、高吞吐、极致弹性和存算解耦的高性能存储能力。
双方围绕 AI 驱动的块存储场景展开深度软硬件协同优化。针对百万级实例创建启动、百毫秒级任务响应以及基础镜像预热分发等高密度管控面场景,双方在调度、缓存、内存和并发等关键环节持续打磨,通过英特尔睿频加速技术(Turbo Boost)、缓存分配技术(CAT)以及 NUMA 感知调度等能力,充分释放至强在计算、缓存和内存层级的优势,提升高密度管控场景下的吞吐与响应效率,实现更加高效的数据访问和资源管理,为大规模智能体应用提供敏捷稳定的运行环境。
在与阿里云共同服务智能体工作负载的过程中,英特尔也将这些实践进一步沉淀为面向智能体 AI 的至强 6 存储平台。面对智能体对存储容量、性能、能效和部署灵活性提出的更高要求,至强 6 凭借双路 192 条 PCIe 5.0 通道,可支持更高密度的存储部署,结合 QAT、DSA 等内置加速器,进一步提升数据处理效率。与此同时,UINTR 与 TPAUSE 指令则帮助系统在高性能与高能效之间取得平衡。通过计算、存储与网络的深度协同,至强 6 帮助客户构建大规模 SSD、高性能 RDMA 网络以及 JBOF 存储层,借助 SPDK 打造低延迟、高吞吐的数据通路,为智能体 AI 提供了高容量、高性能、高能效且易于扩展的存储底座。
在端侧:让千问触手可及
Agent 是 AI 落地的重要场景之一。在端侧场景,推理的核心价值在于保护用户隐私、降低词元成本。对应的打法在于如何解决端侧推理在容量、算力和带宽上所受到的限制。千问通过低比特量化、模型卸载和投机采样,充分发挥英特尔® 酷睿™ Ultra 处理器的性能,在端侧设备上实现高效、可靠、低延迟的运行。
在云栖大会上,阿里云宣布正式开源 Qwen-Image 2.1,为图像生成和编辑工作提供了更多元化的选择。基于英特尔锐炫™ Pro B70 端侧性能的充分释放,Qwen-Image 2.1 在图像生成质量、响应速度和部署灵活性之间实现良好平衡。随着越来越多 AI 能力从云端延伸至终端设备,锐炫 Pro B70 正帮助开发者将创意生产力带到用户身边。
对于希望将图像生成与视觉内容创作能力部署到本地硬件的开发者和专业创作者而言,Qwen-Image 2.1 现已在英特尔平台上获得 Day 0 支持。凭借原生 2K 图像输出、RGBA 四通道支持以及先进的局部编辑能力,Qwen-Image 2.1 以紧凑、高效的 70 亿参数模型,提供专业级生成式 AI 体验。
在 OpenVINO™工具套件的支持下,Qwen-Image 2.1 可运行于英特尔锐炫 Pro B70 显卡以及英特尔酷睿 Ultra 3 系列处理器的集成显卡,将专业级图像生成能力带到搭载英特尔平台的 AI PC 及边缘设备,为本地视觉 AI 创作提供更加高效、灵活的部署选择。
下一代至强,更强大,更从容


云栖大会英特尔展台
智能体 AI 来临后,至强在三类 AI 基础设施中承担不同却同样重要的职责。在 GPU 集群中,它是稳定而高效的机头 CPU。在 CPU 集群中,它是核心枢纽,承担任务编排、推理调度。在存储集群中,它让海量信息被快速调用和持续记忆。在不同的角色中,至强都表现出了持续进化的能力和英特尔在软件与生态上的积累。
这次,全新的 Diamond Rapids 在云栖大会亮相,体现的是至强在性能上的继续演化。面对未来更庞大、更复杂的异构 Agent 工作负载,Diamond Rapids 将用更强大的姿态,帮助客户应对 Agent 场景所提出的各项要求。
来源:互联网