大模型从技术秀场走向业务主战场,推理环节的效率与成本正在成为企业落地的第一道门槛。千亿、万亿参数 MoE、多模态大模型落地过程中,传统服务器无法容纳全量参数,只能拆分部署至多节点集群。算力看似达标,集群组网投入却成倍增加,日常运维复杂度直线上升。
大模型从技术秀场走向业务主战场,推理环节的效率与成本正在成为企业落地的第一道门槛。千亿、万亿参数 MoE、多模态大模型落地过程中,传统服务器无法容纳全量参数,只能拆分部署至多节点集群。算力看似达标,集群组网投入却成倍增加,日常运维复杂度直线上升。
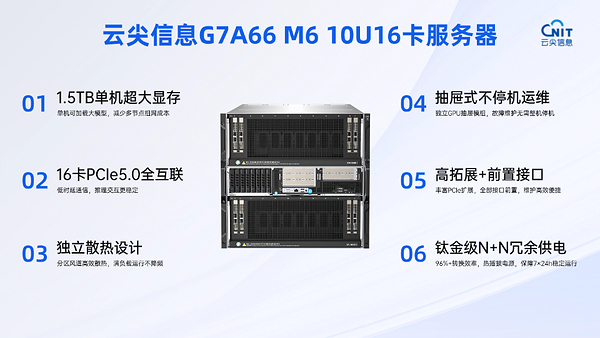
云尖信息秉承单机"算力密度更高、配置组合更多"的创新框架,从底层架构设计出发,推出 G7A66 M6 10U16 卡超高密度算力服务器。单节点显存突破 1.5TB,可直接实现超大模型整机加载,有效减少跨节点网络交互,降低集群组网的交换机投入成本。G7A66 M6 以单节点超高算力密度推动全链路结构优化,一次性解决大模型部署核心痛点,为 AI 规模化落地提供更坚实的算力底座。

云尖信息 G7A66 M6 10U16 卡服务器
单节点 1.5TB 超大显存,16 卡全互联消除跨节点内耗
G7A66 M6 内置 16 张双宽 GPU,单卡显存 96GB,总显存突破 1.5TB,单机即可完成 DeepSeek-V4 Pro 等大模型部署。16 张 GPU 通过 PCIe Switch 实现全互联,任意两卡之间双向带宽均达到 PCIe 5.0 x16 满速上限,卡间通信时延低、带宽表现稳定。在大模型多种并行策略的推理场景下,单节点全互联架构彻底规避了跨机通信损耗,超长文本推理可避免多卡同步卡顿,首包响应更平稳,终端交互体验显著提升。

云尖信息 G7A66 M6 10U16 卡服务器
底层结构革新,细节设计应对三大难题
高密度算力机型通常伴随散热承压、运维困难、定制受限等共性问题,云尖信息通过结构革新,将高密度机型的各项能力提升至全新水平。
在散热方面,G7A66 M6 采用三区独立风道设计,两层 GPU 区与 CPU 区气流完全物理隔离,搭配 20 个 8080 高功率风扇,即便 16 卡满负载运行,也能高效导出各区域热量,避免局部积热导致 GPU 降频,保障算力持续稳定输出。
在运维方面,GPU 模组分为上下两层独立抽屉,维护时只需单独下电并抽出故障层的 GPU 模组,另一层 GPU 与 CPU/IO 主模组可保持正常运行,实现不停机维护。G7A66 M6 采用机框托底滑轨设计,上下 GPU 抽屉由机框内置滑轨承托并配备安全锁扣,满载抽出时重心稳定,还能防止维护时意外滑出,兼顾操作便捷性与设备运行安全。
在扩展方面,G7A66 M6 前置 8 盘位,支持多种存储协议灵活选配,最高可扩展 30 个 PCIe 5.0 槽位,在保障高密度的前提下保留了充足的定制化空间。所有网络、管理接口均采用前置排布设计,在机柜正面即可完成全部接线、排查与更换操作,大幅提升维护效率。

爆炸图:云尖信息 G7A66 M6 10U16 卡服务器
高可靠冗余供电,筑牢稳定运行生命线
供电是 16 卡高密度服务器稳定运行的生命线。G7A66 M6 搭载 10 个钛金级高效率 CRPS 热插拔电源模块,转换效率可达 96% 以上。供电采用 N+N 冗余架构,从根源上杜绝单电源故障引发的推理服务整体宕机,为 7×24 小时在线的推理业务筑牢可靠保障。电源模块支持热插拔更换,运维无需整机断电,进一步压缩业务中断时长。
当大模型推理从"能跑"迈入"跑得稳、跑得省"的新阶段,算力底座的价值早已不再是单纯的硬件堆砌。云尖信息 G7A66 M6 服务器以高密度破局性能瓶颈,以结构革新优化运维体验,以高可靠保障业务连续性,既是大模型推理场景的算力优选,也为高密度算力服务器的演进提供了更具参考价值的方向。
来源:互联网