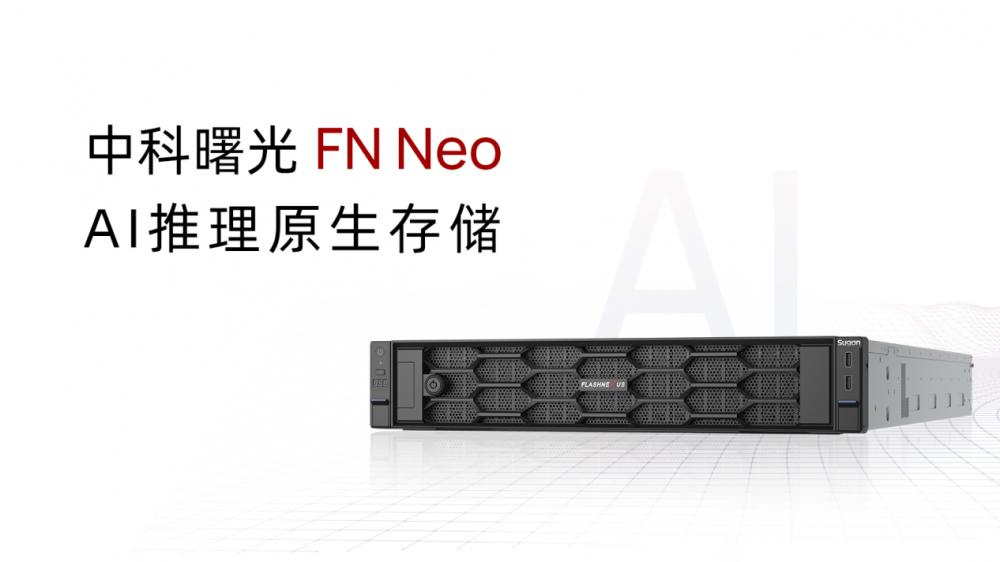
智能体时代加速到来,AI 推理业务规模快速扩张,推理占比持续走高。在大模型与 Agent 业务场景下,KV Cache 已经成为推理环节的核心生产数据,传统节点本地缓存模式资源割裂,难以实现跨会话、跨节点复用,制约大模型推理整体效能。
智能体时代加速到来,AI 推理业务规模快速扩张,推理占比持续走高。在大模型与 Agent 业务场景下,KV Cache 已经成为推理环节的核心生产数据,传统节点本地缓存模式资源割裂,难以实现跨会话、跨节点复用,制约大模型推理整体效能。
针对上述行业痛点,中科曙光在 2026 年 CCF 全国信息存储技术学术会议上正式发布全新迭代升级的 AI 推理原生存储 FN Neo,依托池化共享架构,实现集群级 KV Cache 资源调度,为 AI 推理规模化落地提供全新存力底座。

集中式存储同样适配 AI 推理新场景
行业内长期存在「集中式存储不适合 AI 推理」的固有认知,不少从业者认为推理业务更依赖本地盘的性能表现。事实上,集中式存储的池化共享架构,早已在金融、通信等对稳定性要求严苛的关键业务中经过大规模实践验证,这套成熟能力同样可以迁移到 AI 推理领域。
随着大模型上下文越来越长、并发用户数量激增,本地缓存受单卡、单机硬件边界束缚,极易出现 GPU 显存溢出、资源浪费的问题。FN Neo 立足集中式全闪架构,跳出单节点硬件局限,用统一存储池承接推理业务各类数据诉求,证明集中式存储完全可以胜任高并发、低时延的 AI 推理复杂负载。
池化共享实现 KV Cache 集群级调度复用
在传统推理部署方案中,KV Cache 属于计算节点的私有资源,不同会话之间无法互通,大量宝贵缓存数据被闲置,算力资源难以充分释放。FN Neo 核心突破在于集群级 KV Cache 池化共享能力,将原本绑定在各个计算节点内部的私有缓存,转变为整个推理集群可调度的共享资源。
这意味着推理缓存不再依附于单台服务器,不同模型会话、不同计算节点之间能够灵活读取、复用 KV Cache 数据。集中式存储的价值也由此拓展,从过去主要承载模型权重、业务文件等传统数据,进一步延伸到推理运行时缓存这一动态高频场景,打通大模型推理性能优化的关键一环。
快、稳、开放,让 AI 推理「火力全开」
FN Neo 延续了中科曙光高端集中式存储的高性能基因,实测数据显示,其单阵列带宽可达 160GB/s、亚毫秒级时延,延迟表现、吞吐量和多请求并发数相比传统本地 NVMe 方案均有约 2 倍提升。
作为专为 AI 推理打造的集中式全闪存储,这套方案更可实现模型首 Token 响应时间缩减 73%,整体 Token 吞吐能力提升 150%,显著改善用户交互体验。
面向生产级 AI 业务,仅有性能突破远远不够,稳定可靠与生态适配同样不可或缺。FN Neo 具备 99.999% 高可靠运行保障,通过慢盘自动隔离、故障无损重构等机制,保障推理业务 7×24 小时不间断运行。
同时,产品打造 SAN/NAS/KV 三重协议一体化开放生态,可无缝对接 vLLM、LMCache、Mooncake 等主流推理框架,企业无需大规模改造现有推理环境即可完成接入。通过存力资源池化,减少多节点重复存储开销,提升 GPU 等昂贵计算硬件的整体利用率。
FN Neo 的推出,补齐了 AI 推理场景下集中式存储的能力拼图,为 Agent、长上下文大模型等业务的大规模落地,提供了一套经过工程验证的存力新选择。
来源:互联网