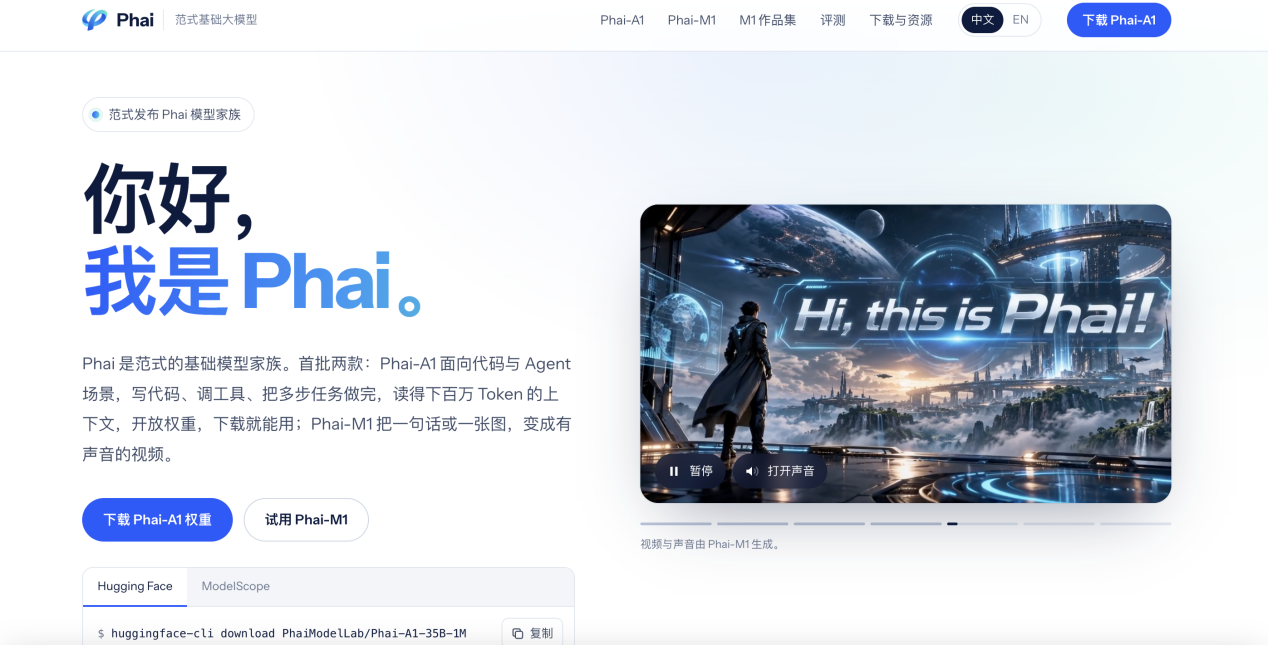
范式智能技术集团(6682.HK)正式发布 Phai 系列两款自研模型:通用语言模型 Phai-A1 与视频生成模型 Phai-M1,支持原生百万级上下文,并完成昇腾平台全流程国产算力训练优化。
北京,2026年11月18日 - 范式智能技术集团股份有限公司(“范式” 或“集团”,股票代码:6682.HK,原第四范式) 正式推出 Phai 系列两款自研模型:通用语言模型 Phai-A1及视频生成模型 Phai-M1,分别面向代码开发、智能助手等语言类场景,以及视频内容创作场景。
Phai-A1重点优化推理效率与长上下文处理能力,支持原生百万级上下文窗口,可在个人电脑本地部署;Phai-M1针对真人影视场景进行训练优化,重点改善人物呈现、画面细节和音画协同效果。两款模型分别从推理性能、视频生成品质出发,落地验证AI模型在真实业务流程中的应用价值。
范式创始人兼CEO戴文渊表示:“AI产业正从单一模型能力的竞争,走向算力、模型与应用协同发展的新阶段。推出Phai系列,是范式夯实AI全栈技术布局的重要一步。通过自研模型与国产算力平台的协同调优,我们能够打通底层算力与上层应用,让模型能力贴合业务需求,同时用真实场景的反馈持续反哺模型迭代,持续增强集团整体技术实力与产品竞争力。”
Phai-A1:高效推理,支持百万级上下文与本地PC部署
Phai-A1 聚焦代码开发、智能助手等应用场景,核心优化推理速度和长文本理解,可支持代码编写、问题修复、工具调用及多步骤任务处理。
推理性能上,根据测试数据,同等单卡RTX 3090运行环境、相同代码智能体任务下,Phai-A1响应速度较 Qwen 27B 提升约 8–10 倍。对于高频调用、低延迟需求的业务,轻量化模型按需调度,既能加快响应,也为企业控制大模型调用成本提供新方案。
在代码能力上,Phai-A1在SWE-Bench-Verified、SWE-Bench-Pro及SWE-Bench-Multilingual等多项软件工程权威评测中取得了良好表现,部分评测结果达到更大参数规模模型的水平。
长上下文处理是Phai-A1的另一大亮点。模型支持原生百万级Token上下文窗口,后训练数据覆盖超长文本场景,可读取完整代码仓库、长篇文档、海量资料,支撑长时间连续对话,承接复杂综合性任务。
此外,Phai-A1支持在个人电脑上本地部署。开发者和企业可根据硬件条件、数据合规要求选择本地运行,在数据管控、部署方式、成本结构上拥有更高灵活性。
Phai-M1:面向真人影视场景,兼顾画面质感与生成效率
随着AI视频生成逐步进入内容生产链路,人物自然度、画面精细度、出片速度,直接决定落地体验。
Phai-M1是面向视频创作的模型,以真人影视场景为训练重心,重点优化人物表情、肢体动作与画面细节,解决AI视频常见的失真问题,适配真人剧集、AI短剧等内容生产需求。
功能层面,Phai-M1支持音画同步生成,在同一生成流程中同步输出画面与音频,进一步丰富成片表达。效率方面,根据实测数据显示,Phai-M1生成一段15秒、720P视频约需3分钟。对于稳定产出素材的短剧团队、内容工作室来说,生成速度直接影响创作节奏与制作成本。
围绕人物表现、画面质感、音画同步、出片效率四大方向持续优化,Phai-M1 旨在拓宽 AI 视频在影视、短视频工业化生产中的落地边界。
昇腾平台全流程后训练优化,推进国产算力深度协同
模型能否落地,除自身能力外,和底层算力平台的适配协同同样关键。
依托ModelHub XC社区支持,Phai系列模型完成华为昇腾平台全流程后训练优化,适配国产算力环境的运行特性,探索模型能力与国产算力平台的深度融合。
对于企业用户而言,模型与国产算力平台的协同优化,有助于提升国产算力资源的使用效率,也为企业在自主可控的算力环境中部署和应用AI提供了更多技术组合选择。
目前,Phai系列模型已与范式旗下ModelHub XC、HAMi、ModelSphere等技术产品打通,并接入PhanthyCode、PhanthyMovie等上层应用,形成从模型研发、算力基础设施到 AI 应用的完整链路。
面向全球开发者开源
为了让更多开发者了解和使用Phai系列模型,范式计划未来不久开放Phai-A1及Phai-M1模型权重。
后续范式将持续迭代模型能力、拓展落地场景、深化生态合作,吸纳开发者反馈驱动版本升级,推动 Phai 系列在代码开发、智能办公、视频创作、企业私有化场景落地。