讯飞,正在挖掘新的商业模式。
10 月 22 日,科大讯飞全球1024开发者节上的一个半小时里,刘庆峰和同事们轮番上台,从云端大模型讲到端侧模型,再讲到教育、医疗、汽车和机器人。会场一侧搭了一家 24 小时营业的机器人小店,演示中途,台下嘉宾还喝上了一杯用 AI 眼镜点来的咖啡。
讯飞这次推出了一个 4B 参数的端侧模型,能在不联网的情况下,读完一位总经理邮箱里所有的大区周报和附件,找出两个团队在同一个单子上撞单报价的风险。
把模型做小,放到离用户和数据更近的地方,这是理解讯飞这一轮布局的主线。 模型怎么做、场景怎么选、最后卖给谁,几乎都是从这里展开的。
从底座到端侧,什么是最关键的?
要理解讯飞为什么这样做,得先看它的底座。刘庆峰在台上放了一张大模型对比表,特别强调星火是表上唯一用国产算力训练的模型。国产芯片做大模型,一个现实的难点是显存带宽,这在长上下文训练上影响尤其大,而眼下最热的代码和智能体,恰恰最吃长上下文。
讯飞这次的解法,是一套适配国产平台的动态并行训练器,把长程和短程任务自动拆开调度,超长上下文的训练效率提升了 4 倍。简单来说,就是让模型从「训不动」变成了「能训」。这次发布的云端模型星火 X2.6,就是在这个基础上训出来的,采用 293B 总参数、30B 激活参数的 MoE 架构,上下文拓展到 1M。推理侧,讯飞基于国产集群做了四层 KV Cache 和分布式推理,推理效率提升 4.5 倍。
但讯飞很清楚,追平需要时间。刘庆峰自己的判断是,国产算力和全球最好水平还差两代左右。所以它一边在云端补课,一边把更多资源放在了另一头,端侧。
讯飞同步开源的端侧模型星火 X2.6-4B。「选 4B 不是随便定的,这是机器人、汽车、PC 上恰好放得下的尺寸,再大就装不进去。」刘庆峰说道,按讯飞公布的测评,它在同尺寸里领先千问和 Llama,综合表现超过一些 9B 模型。它的上一代 X2.5-4B 在 9 月 1 日开源,据讯飞介绍,下载量已进入全球端侧模型前四。
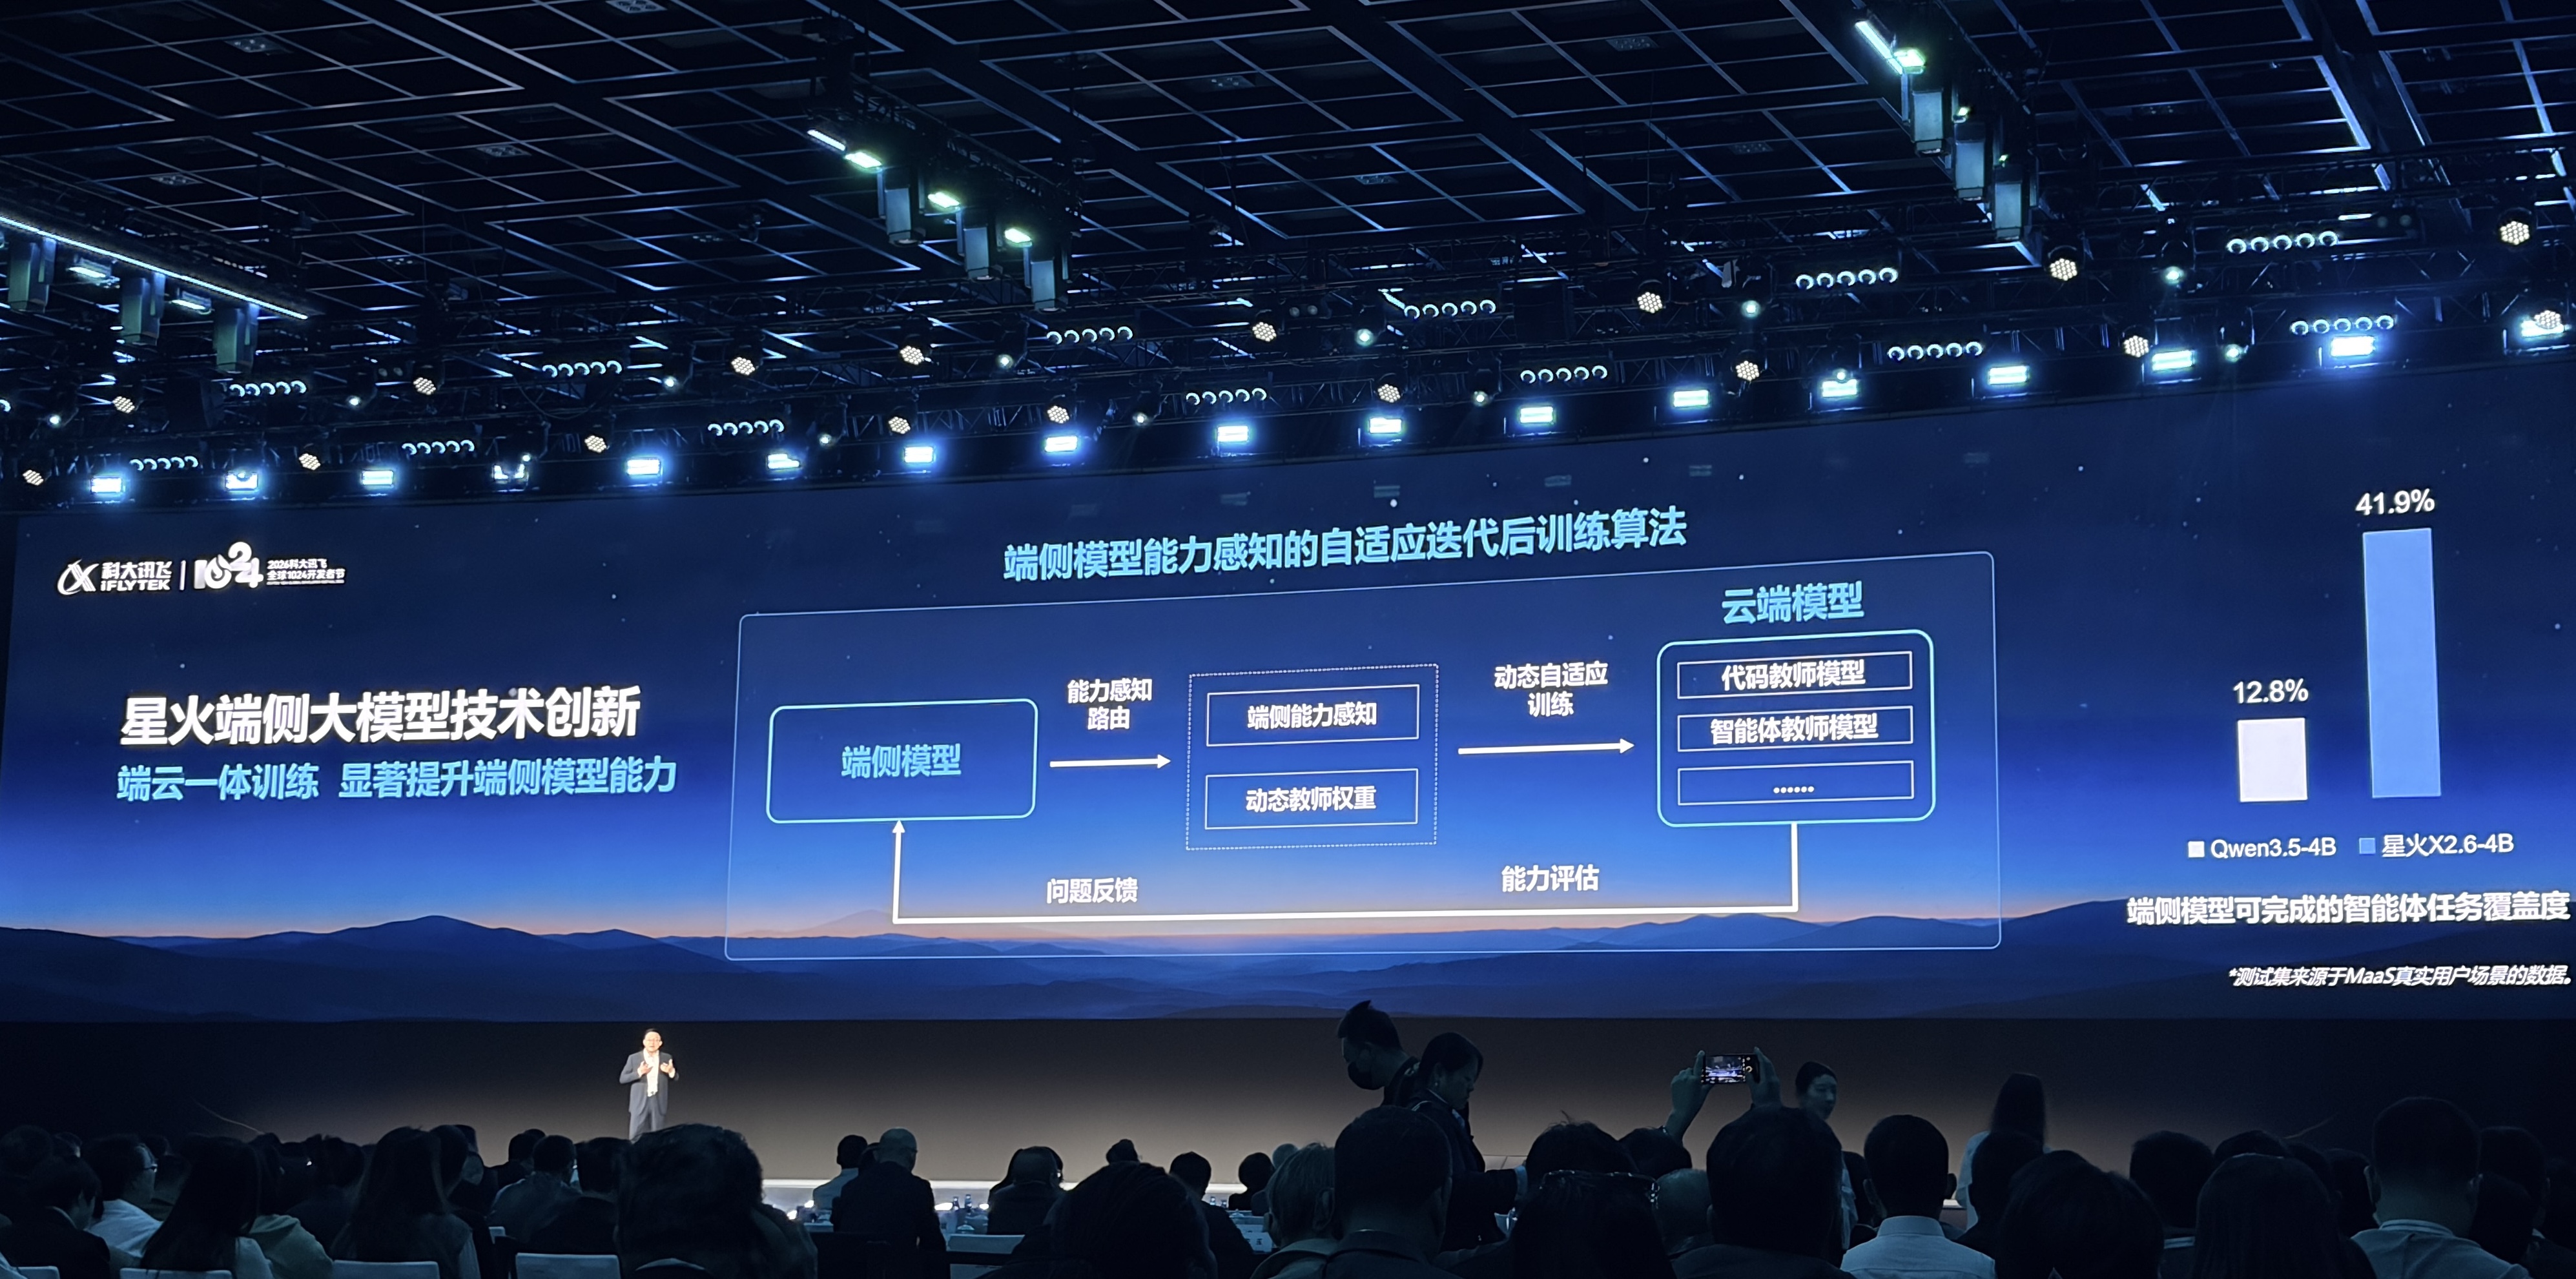
比跑分更关键的,是它和云端的关系。讯飞在云端搭了一个「教师模型池」,让小模型自己判断哪些事能做、哪些做不了、该向哪个云端模型学。这样训出来的 X2.6-4B,端侧可完成的智能体任务覆盖度达到 41.9%。刘庆峰在现场给的参照是,此前同尺寸模型里表现较好的,也只有 12.8% 左右。端云之间该谁来干活的路由判断,准确率也从 81% 提到 90.1%。
刘庆峰给出的分工设想是,未来 60% 的应用在本地完成,30% 靠端云协同,只有 10% 需要云端大模型来解决。
这是讯飞把算力短板翻译成产品主张的方式。云端负责教,本地负责干,让数据尽可能减少流转的过程。
模型可以追,场景很难抢
有了端云一体这套底座,讯飞并没有去做一个什么都能聊的超级助手。它把模型塞回了自己经营了二十多年的那些场景里。
最典型的是教育。这是讯飞的老本行,也是它最舍得下功夫的地方。讯飞想做的不是一个会答题的 AI,而是一个懂老师的助手。演示里让它做一个「通电螺线管周围磁场」的交互动画,它没有直接开画,而是先去对照新课标、教材和教学目标,做完了还提醒老师可以补一个右手螺旋定则的演示。按讯飞的说法,教师助手的满意度它拿到 4.7 分,同行没有超过 4.0 的。
刘庆峰在收尾时把这条线讲得更远。会答题只是大模型秀技,接下来要会批改,要知道错在哪,要据此推荐学习内容,最后还要让孩子爱上学习。这是一份只有长期扎在学校里的公司才写得出的路线图。
医疗和科研,则是端云一体最有说服力的地方。实验室的原始数据和研究方法,是最不敢交给公有云的东西。讯飞的做法是让云端模型先学会各类科研任务的分析逻辑和写作方式,沉淀成本地可调用的「技能」,再由端侧模型拿着私有数据去干活。现场演示里,模型读入一组糖尿病研究数据,在本地完成建模、出图、按范文排版,生成了一篇完整论文,全程没有离开这台电脑。
云端教方法,本地碰数据。 这句话几乎可以概括讯飞这次所有的场景设计。
车和机器人,是 4B 这个尺寸真正的用武之地。讯飞做车载语音多年,这次的智慧座舱 3.0 可以一句话规划完所有途经点,人站在几十米外也能把车叫到面前。机器人这边,讯飞不造本体,只做耳朵、嘴和一部分脑子。据它披露,机器人超脑平台上已经有近 500 家公司,国内头部机器人企业 90% 是它的客户。
他还展示了一段机器人小店的演示。小朋友要酸奶,妈妈随口提了一句孩子刚闹过肚子,机器人马上接话,建议换一个。几个人同时说话时该听谁的,看到孩子手里拿着什么就主动搭话,这些都是讯飞在语音交互上攒了二十多年的东西,也是对场景的理解。
自主可控,本身就是产品
模型和场景都摆完,讯飞真正的行业落点也就浮出来了。那些数据不能上公有云、采购要求自主可控、业务流程又足够复杂的机构,无论是央国企、政府部门、医院、律所、科研院所,都在这个需求范围内。
「过去一年各种提效工具层出不穷,个人用 AI 确实快了,企业整体的效率却没有跟着明显提升。」刘庆峰认为,AI 得真正读懂 ERP、CRM 里的业务数据,还得嵌进流程,跟真人分好工。为此讯飞发布了星帆 WinWork 数字员工平台,支持全栈国产化和私有化部署,过程可审计、可追溯,讯飞称借助端云一体模型能节省 44% 的 Token 消耗。
供应链那个演示把这件事讲得很具体。一家供应商被列入失信名单,采购侧的数字员工第一时间发现,拉起财务、法务、采购三方的工作群,三个部门的数字员工并行开工。如果中间出了分歧,法务建议按合同解约,采购却指出一解约就会断供。系统没有自己拍板,而是把分歧交给负责人。负责人决定先不解约,修订合同兜住风险,等备选供应商接产再切换。前后不到半天。
再往下一层,讯飞推出了基于星火端云模型和国产操作系统的 AIPC 系列产品,再配上和麒麟操作系统联合做的系统级安全防护。国产算力训练的模型,跑在国产系统和国产硬件上,数据不出本地。
对一家政企客户来说,这几乎是一张已经写好的信创采购清单。讯飞卖的不只是模型能力,而是「自主可控」这件事本身。 而这类客户,讯飞已经服务了二十多年。
到这里,讯飞的战略其实形成了一个闭环。国产算力逼出了端云一体的路线,端云一体让私有化部署变得可行,私有化部署对准的政企客户,又恰恰最需要国产算力。
当然,这个闭环也有它的老问题。私有化部署向来交付重、毛利薄,这是讯飞多年被质疑的地方。41.9% 的端侧任务覆盖度是一次大跃迁,但换个角度看,还有六成要靠云端。发布会上的数字员工跑得很顺,真实企业里系统老旧、数据脏乱,落地会慢得多。
刘庆峰在台上说,国产算力和全球最好水平的差距,会从两代缩到一代,再缩到半代。
讯飞的整套打法,就是押在这段追赶期上。算力慢慢追,场景先占住。等芯片追上来的那天,它希望自己已经守在那些最难进的门里了。