优必选推出统一多模态世界模型Thinker-WM,在三大具身世界模型基准登顶。其核心是在表征层统一RGB、深度与动作,由共享UDT联合演化,单模型支持六大能力;依托约3万小时异构数据与Data Factory训练,Motion Probe验证跨模态耦合,并已在机器人平台部署验证,后续将在Thinker Cosmos持续更新。
01 三大基准全榜登顶,Thinker-WM 斩获三项第一
日前,优必选 Thinker-WM在三大公认具身世界模型基准评测中全部拿下第一名,刷新行业成绩:
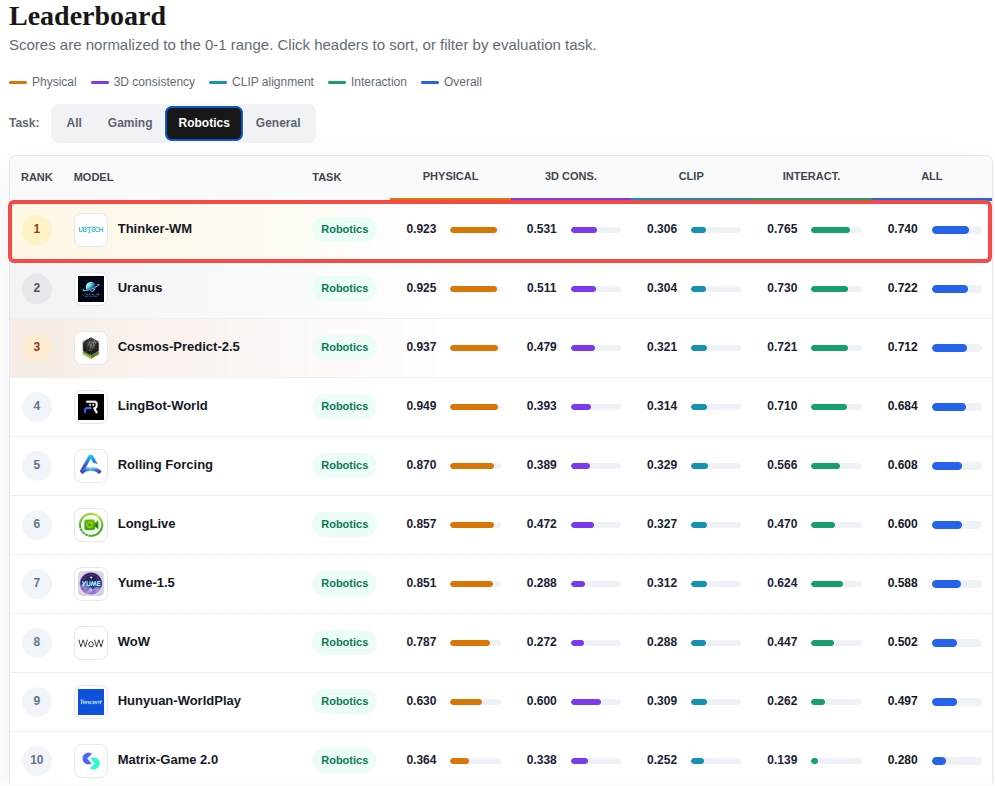
WorldOlympiad:
Thinker‑WM 取得综合得分 0.740 位列榜首。该基准基于大量真实机器人交互数据构建,覆盖十余种不同机器人本体与多类相机配置,重点考核模型跨机器人形态、跨视角的泛化能力。模型取得 3D 一致性 0.531、交互保真度 0.765,两项单项指标位居全部参评模型首位,体现模型对三维几何结构与机器人交互过程的精准建模能力。
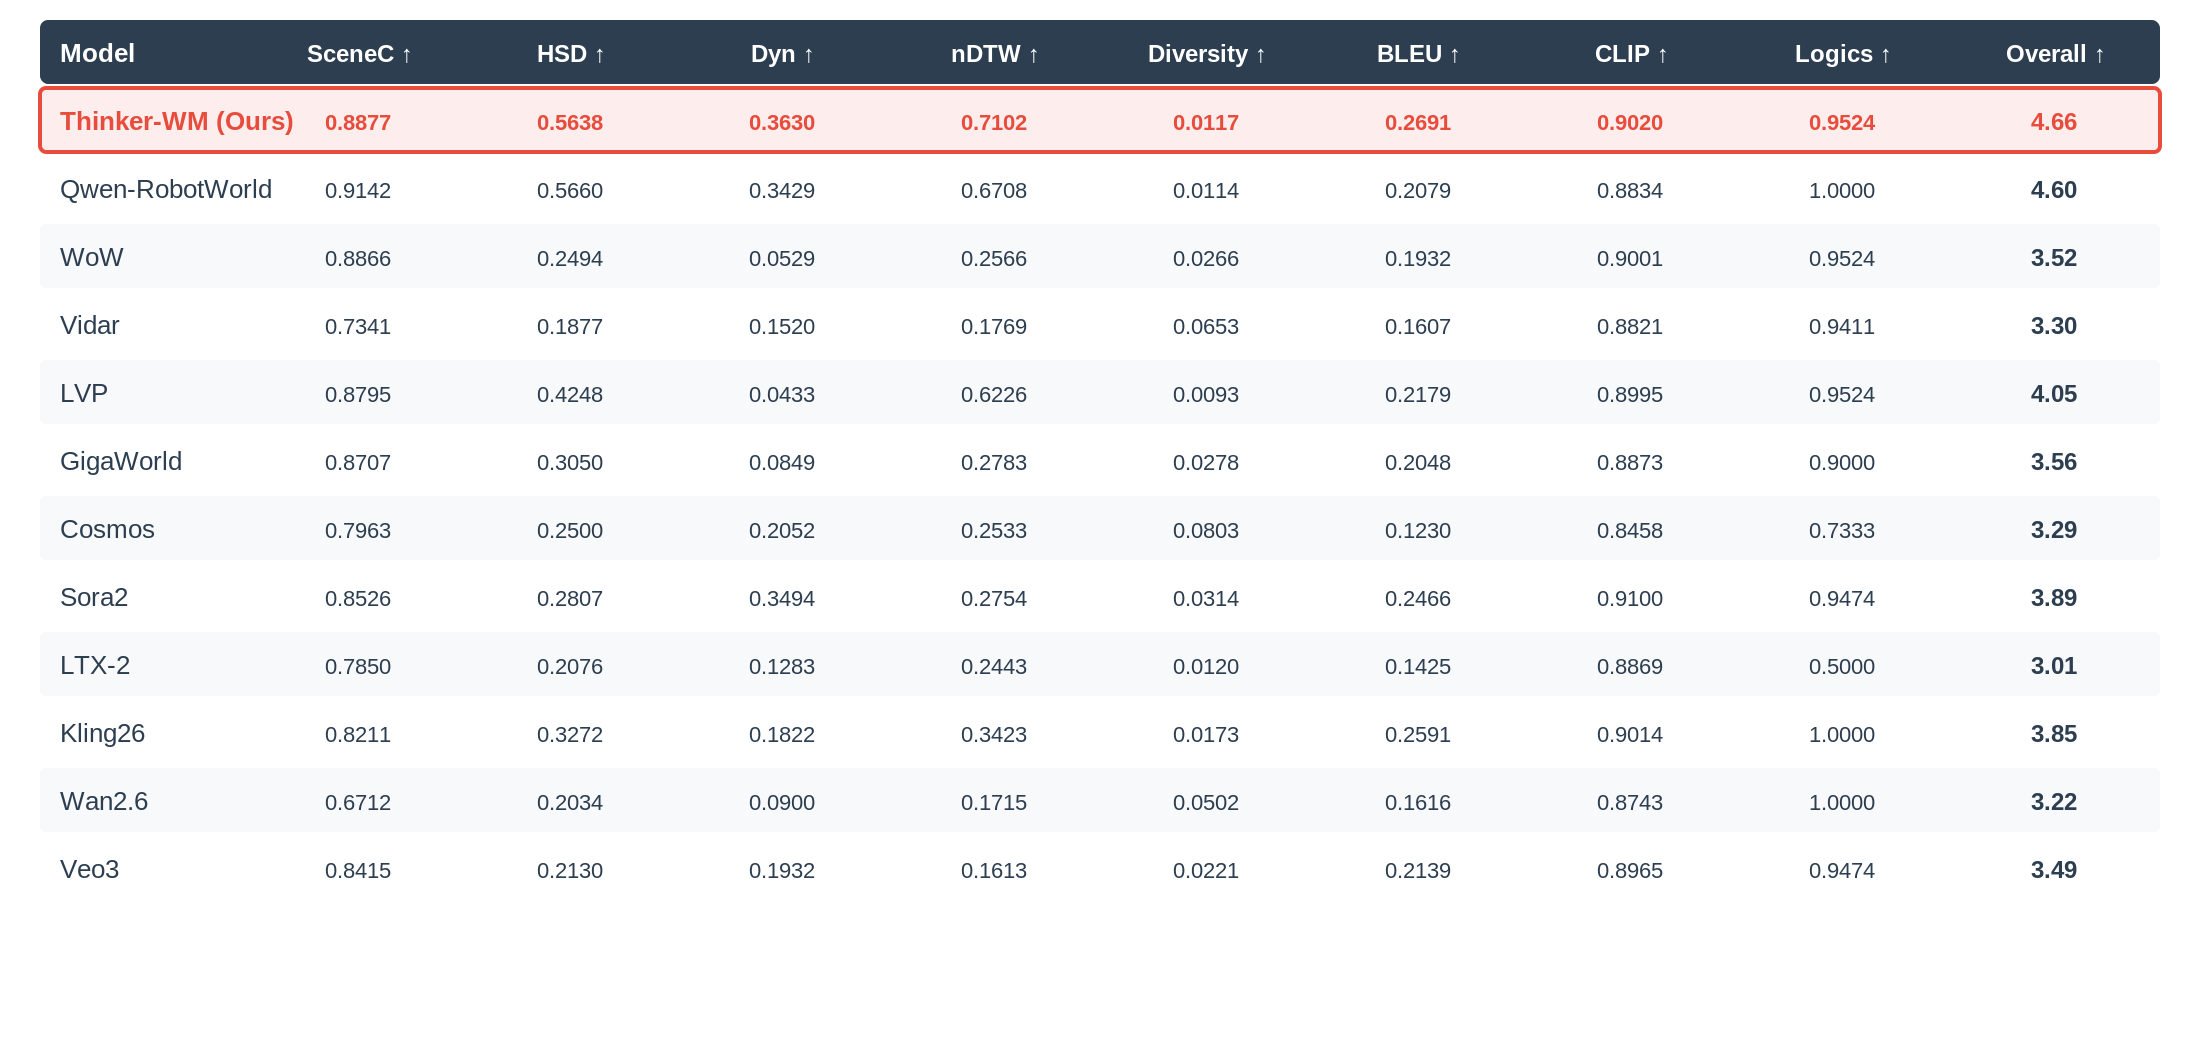
EWMBench:
Thinker‑WM 取得综合总分 4.66,超过 Qwen‑RobotWorld、Sora2 等主流模型。EWMBench 完整考核场景一致性、机器人末端运动正确性、指令语义对齐三大能力维度。得益于表征层面的多模态联合建模,Thinker‑WM 在反映机器人轨迹时空匹配的 nDTW(归一化动态时间规整)、表征运动速度与加速度合理性的 Dyn(动力学一致性)等机器人运动核心指标上实现领先。
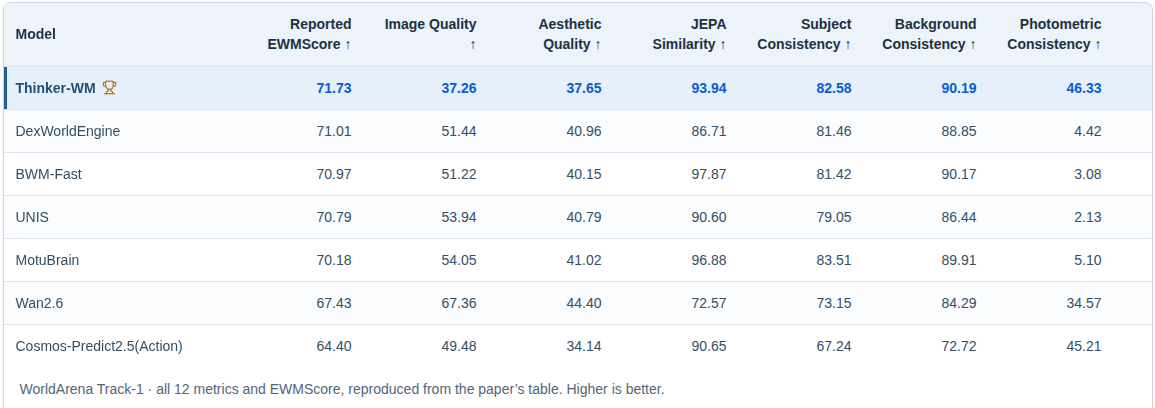
WorldArena1.0 Track-1:
在仿真环境基准 WorldArena Track‑1,Thinker‑WM 在视觉画质、内容一致性、物理合理性、3D 几何精度、指令遵循等 12 项关键评价维度整体领先,兼顾仿真环境下视觉生成质量与物理交互可信度。Thinker‑WM 以表征层统一的 Unified Dynamic Transformer(UDT)为核心,将 RGB 图像、度量深度、机器人动作纳入同一套共享动态表征联合演化,实现视频‑动作联合生成、世界预测、策略推理、视频转动作、逆动力学等多项能力合一,为具身智能提供新一代基础世界模型底座。
02 Thinker-WM技术突破:表征层面实现视觉、几何、动作多模态统一
让机器人在真实世界落地干活,最难的不是识别眼前物体,而是预判环境下一步变化。这也是世界模型存在的价值与意义,而过往世界模型普遍采用 “拼接式” 方案:视频生成负责画面、策略网络负责动作、几何预测负责空间信息,模块独立计算,再通过接口拼接输出。
但这套技术模型的问题在于,动作改变环境、环境约束动作,几何结构同时影响两者,物理上紧密耦合的信号被拆分到不同模块,丢失其内在因果关联。
举个例子,“一个杯子被推下桌子”这件事情,在语言里是一句话描述,在动作里是一串关节命令,在视频里是一段穿越画面的物体运动,在深度里是一组连续变化的距离场。四种表述指向的是同一个事件,而不是四个不同的对象。所以,要求模型生成其中任何一种,本质上都是在追问同一个过程。
但这种重叠又是不完全的。动作既不携带外观,也不携带上下文,同样的关节命令,放在空桌子上和放在杂乱的桌子上,含义完全不同。语言也不携带时空细节,“杯子被推下桌子”这句话,既没有规定从哪一侧推、用多大力、以什么速度推,也没有规定手的具体轨迹、杯子翻转几圈、最终落在哪里。视频不携带显式几何和度量,其仅使用一系列像素表示,既不知道杯子的尺寸,也不知道杯子的距离。深度也不携带外观、命名语义和意图,它给出表面在哪里、如何遮挡、如何接触,却不告诉你那是杯子还是桌布,更不告诉你为什么要推它。
针对这个问题,优必选 Thinker 团队给出全新解法:不在接口处做简单合并,而是在表征层面实现多模态统一。Thinker-WM(Thinker World Model)作为优必选自研统一多模态世界模型,将 RGB 视频、深度和机器人动作编码至同一个中间表征空间,依靠一组共享参数联合演化。外观、几何、动作不再是三条独立流水线,而是同一个世界演化过程的三种表达形态。也就是说,Thinker-WM 的底层设计逻辑可以概括为:不同模态是同一过程的不同表述;模型将它们对齐到共享表征空间,并在这一共享表征上进行推理,而不是在模态接口上做条件组合。
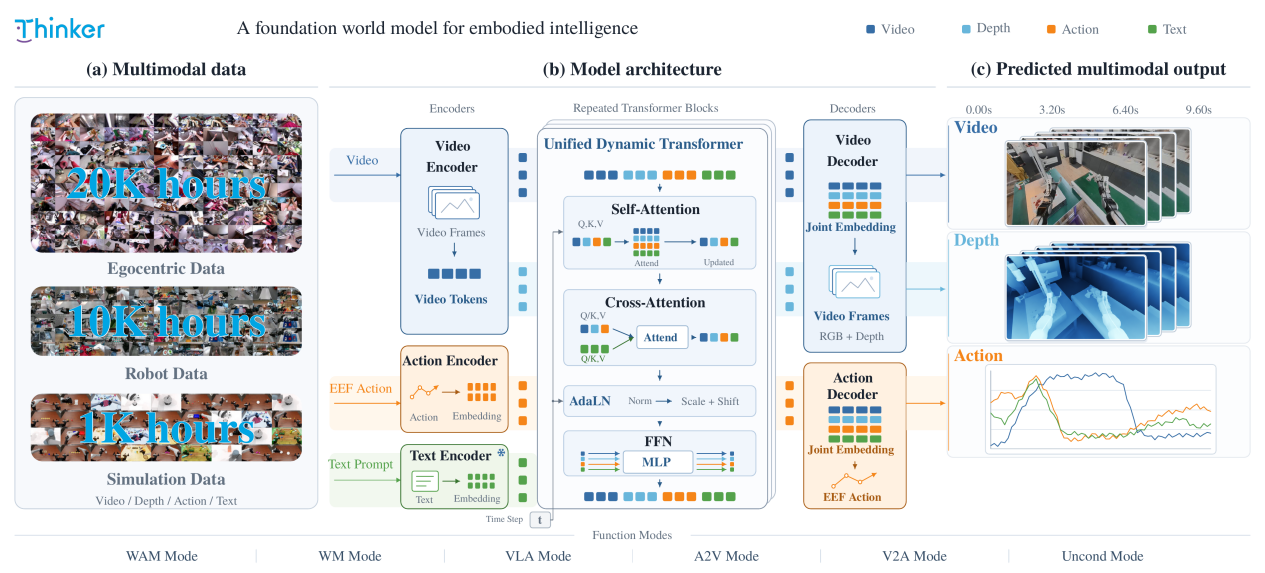
Thinker-WM:视觉、几何与动作的统一建模框架
具体来看,RGB图像、深度信息、机器人动作分别通过各自的编码器映射到统一潜在空间,送入共享的统一动态Transformer(Unified Dynamics Transformer, UDT)进行联合时序建模,最终由各自的解码器还原输出视频、深度图、机器人可执行动作。这就意味着多模态的交互发生在Transformer内部,视觉token、几何token和动作token通过同一个注意力机制直接交换信息,而不是在输入或输出层做浅层拼接。
几何信息也不再只是辅助监督信号。Thinker-WM 把深度作为原生生成模态,与视频共享一致的潜在拓扑和时空组织。深度监督直接塑造共享表征,让物理空间结构成为世界模型的 “母语”,而非后期外挂补充模块,从而也能帮助人形机器人更准确地理解物理空间。统一建模的价值,也体现在机器人的实际执行效果上。在 RoboTwin 单任务消融实验中,引入深度模态后,操作成功率较无深度基线提升了 15 个百分点,说明空间几何信息不仅有助于模型理解场景,也能改善动作生成与任务执行。
03 3万小时异构数据,让一个模型,解锁六种能力
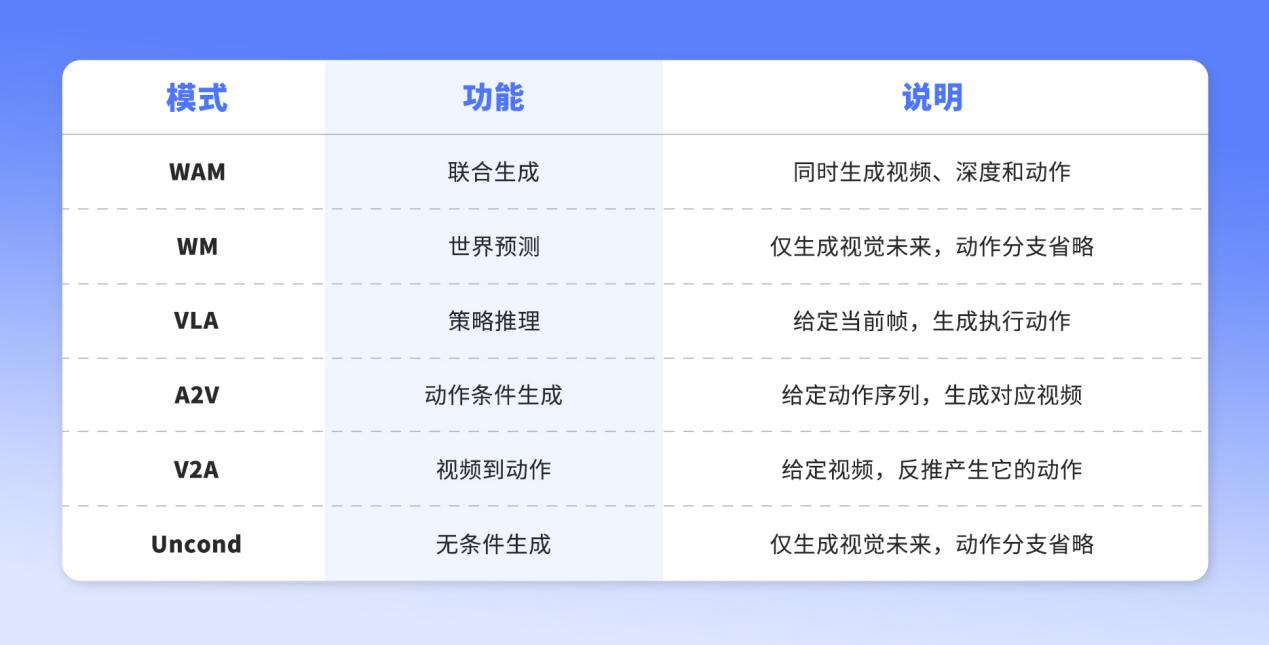
依托多模态统一表征,所有模态共享同一组参数,Thinker-WM 可以通过灵活切换条件模态与生成模态,支持六大能力模式。
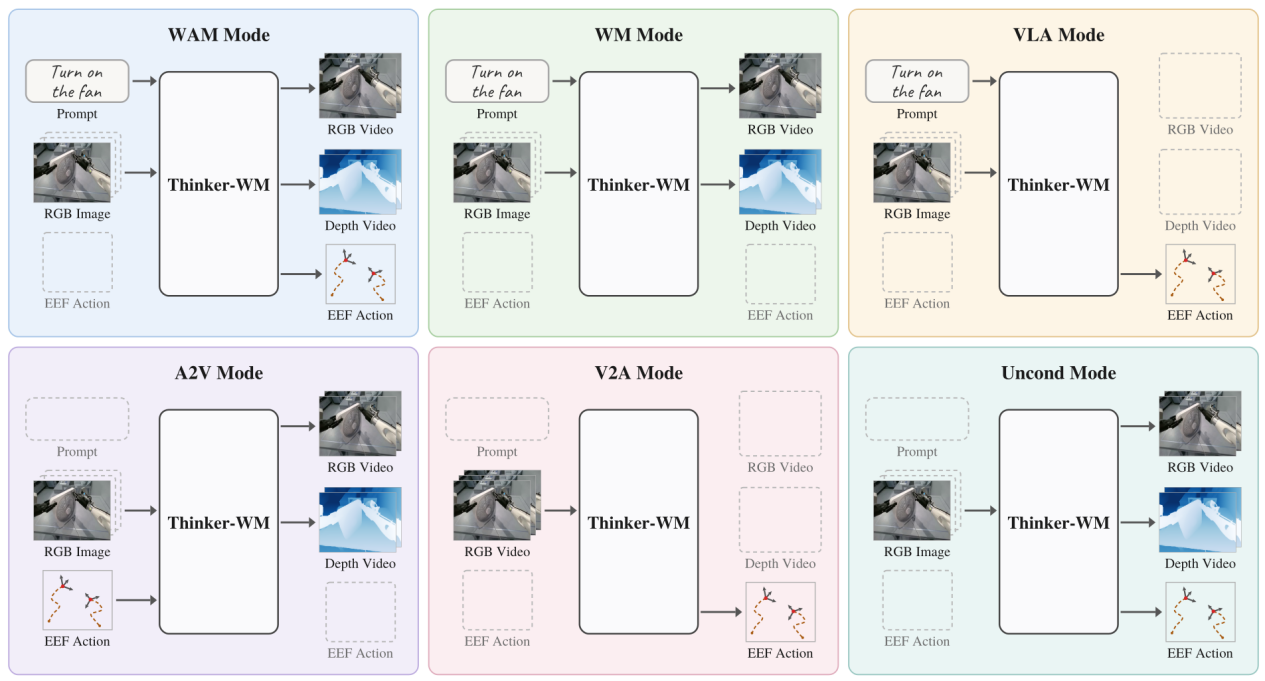
同一份权重,既能预判、想象未来画面,也能反向推演机器人执行轨迹,还能从视频中提取动作信息,这正是统一表征带来的核心技术红利。
04 3万小时异构数据,撑起通用世界模型底座
统一表征能力的背后,是优必选规模丰富、类型多元的训练数据支撑。Thinker-WM 训练语料在具身智能领域具备可观体量:
- 约2万小时第一人称人类视频:覆盖家庭、商业零售、工业等场景,补足机器人遥操作难以低成本获取的任务、物体与场景多样性,同时配套约 1 千小时的对齐深度数据。
- 约1万小时真实机器人数据:来自多款不同形态机器人,提供视觉观测与可执行动作的配对监督,其中约 3 千小时配套对齐深度标注。
- 约1千小时仿真数据:提供高精度几何、物理监督信号。
不同机器人动作空间、坐标系、控制协议差异巨大。Thinker-WM 的统一思想不仅应用于模型框架上,也应用于数据选择中。该模型统一使用末端位姿表示所有机器人动作,同时为不同机器人在token中嵌入专属标签。这样不同形态的机器人可以共享同一个生成空间,又能够保留精准的本体控制能力。
05 数据 Infra:让海量异构数据高效支撑统一模型训练
海量数据要转化为模型能力,离不开稳定、高效的数据基础设施。面对不同机器人、人类视频与仿真数据在格式、模态和标注上的差异,优必选 Thinker 团队构建了 Data Factory,将数据管理与训练采样解耦,让多源数据按模型需求灵活组合。
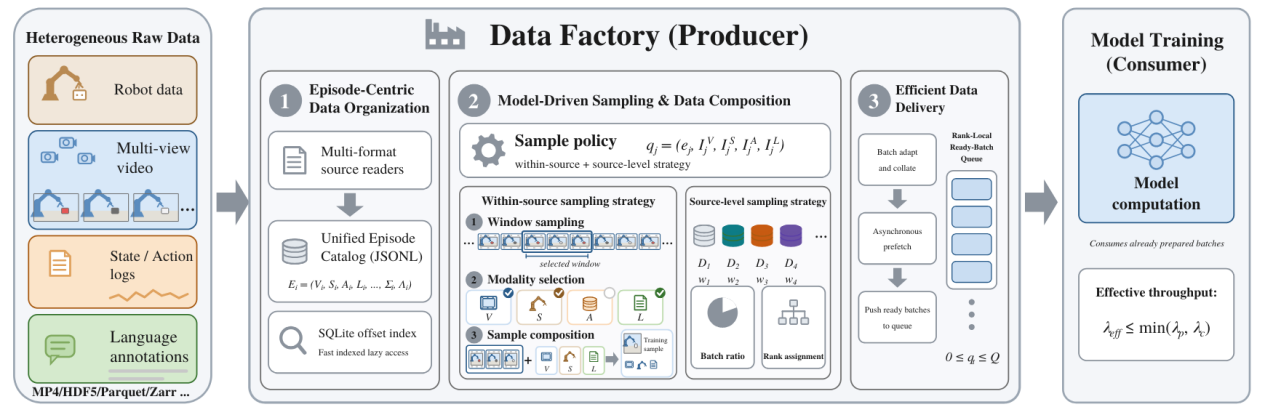
Data Factory:从多源异构数据到统一模型训练
Data Factory 围绕三个关键环节支撑训练:统一组织视频、状态、动作与语言信息,按需生成不同训练模式所需的样本;通过分层质检过滤异常片段,检查深度与视频对齐,确保训练信号可靠;通过异步预取与编码复用提前准备训练数据,减少等待与重复计算。
这套数据基础设施,让多源异构数据能够被可靠组织、灵活调用、高效供给,为 Thinker-WM 六种能力模式的联合训练与持续迭代提供工程支撑。
06 通过Motion Probe实验设计,轻量化实验:验证跨模态表征真实耦合
表征层面统一多模态,听起来是架构设计上的创新,但有一个核心疑问:模型究竟是真的在共享空间学到视觉、几何、动作之间的耦合关联,还是只是并行处理多路信息,把不同模态简单放在一起?
为回答这个问题,优必选Thinker 团队设计了轻量级 Motion Probe(运动探针)验证实验。研究团队在冻结的UDT视觉表征上接一个极小的运动预测头,只训练这个头,看能否从纯视觉表征中恢复出末端执行器的位移。
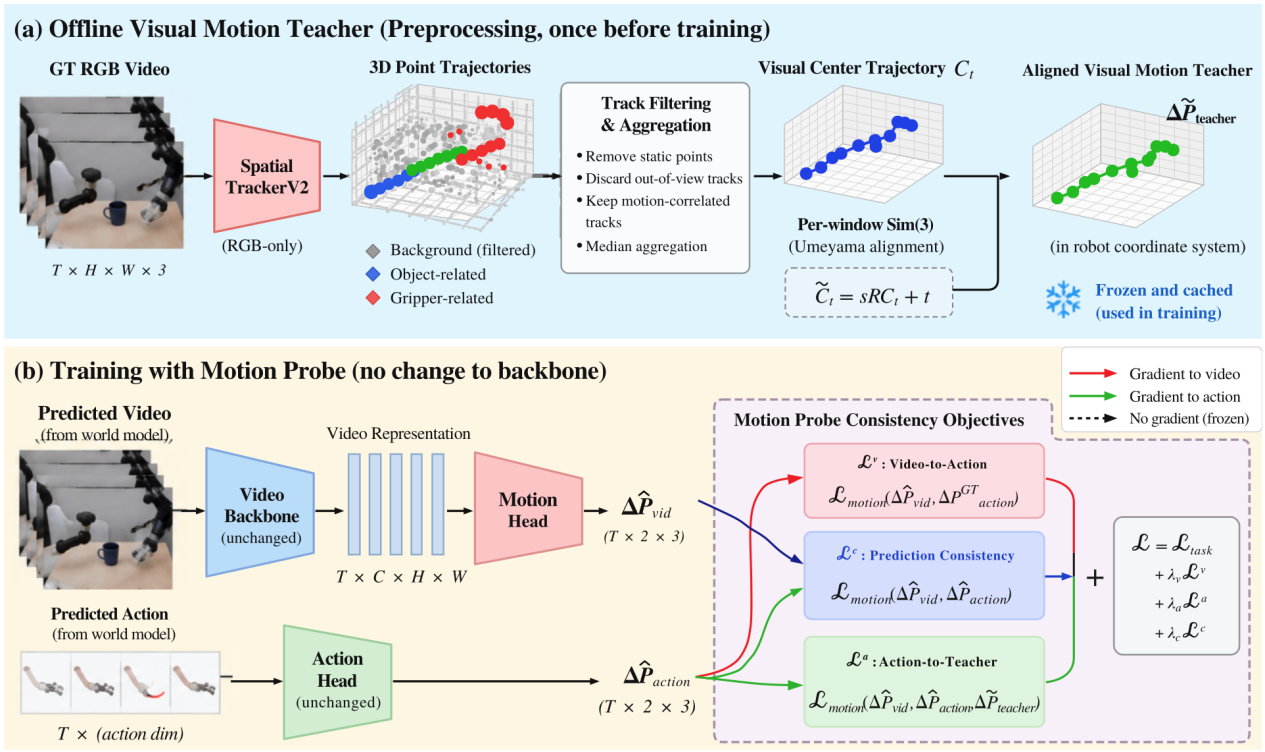
Motion Probe示意图
实验结果证实猜想:探针预测误差很低。即使没有动作监督,视觉表征中也已经编码了与动作相关的运动信息。这一结果直接证明,表征层面的多模态统一真实生效,视觉感知和动作规划不是两条相互独立的链路,而是在共享潜在空间里实现深度耦合。
07 这意味着什么
这也进一步说明,Thinker-WM本次技术的突破的,价值远不止一次刷榜成果。它指明具身世界模型的底层新范式:
具身智能的世界模型不应该是 “视频生成器 + 策略头” 的简单组合,而是一套完整统一的生成过程——视觉观测、空间结构、动作规划,是同一个物理世界过程的不同表达。
当机器人能够在同一表征空间内同步推演画面变化、空间结构、动作轨迹,它对物理世界因果逻辑的理解便向前迈进一大步。这也是机器人从“可以执行任务干活”,迈向“能够理解真实世界”的关键跃迁。
Thinker-WM 现已完成在优必选机器人平台上部署验证,相关技术将持续赋能下一代具身智能系统。
Thinker-WM 的探索不止本次成果发布。模型技术报告与后续迭代版本将在优必选官方具身智能开发者社区Thinker Cosmos 持续更新;世界模型二次开发能力开放计划、技术解读直播预告,也将第一时间面向开发者公布。欢迎加入Thinker Cosmos(https://thinkercosmos.ubtrobot.com/),共建具身智能生态。
项目链接
论文链接: https://arxiv.org/abs/2610.18447
项目地址: https://thinkercosmos.ubtrobot.com/thinker-wm
Github: https://github.com/UBTECH-Robot/Thinker-WM
Huggingface: https://huggingface.co/UBTECH-Robotics/Thinker-WM