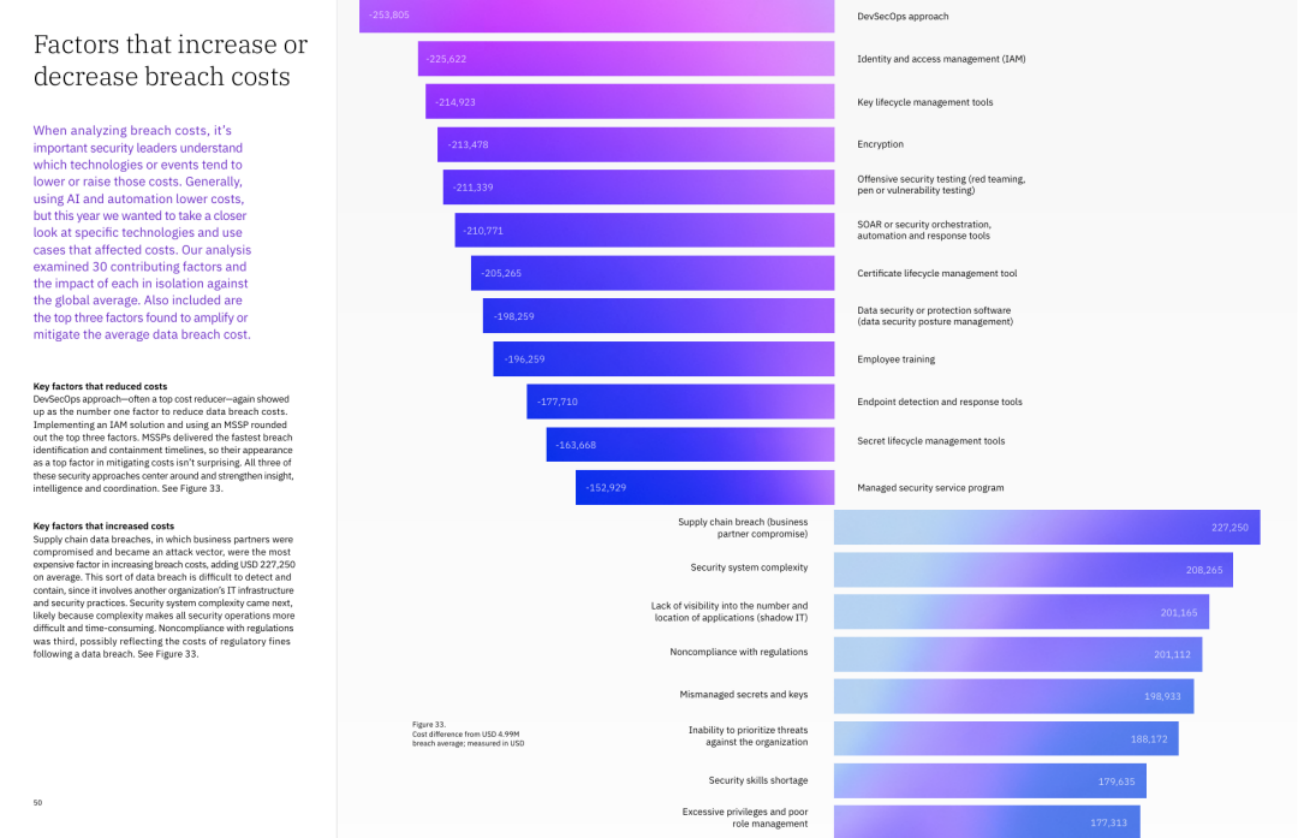
最近有开发者发现,AI 工具可以在后台把整个项目打包加密后反复往云端上传,包括代码、修改记录、密钥和未提交的草稿。
最近有开发者发现,AI 工具可以在后台把整个项目打包加密后反复往云端上传,包括代码、修改记录、密钥和未提交的草稿。
这不是某一家坏了规矩,AI 工具要真正好用,就必须理解整个项目,而不只是补全你正在敲的那几行代码。文件之间的关系、历史的修改、依赖的结构,它都得看得见。这决定了它必须把材料拿到手,也决定了它的默认行为天然偏向"多拿一点,保险一点"。
问题不出在功能本身,而出在这套默认行为没有边界:用户关不掉,也验证不了。开关关了后台还在传,本地包删了又自己长回来,失败几百次还在重试。看起来都像 BUG,真正难修的却是边界:哪些东西本来就不该被装进上传队列中。
关得掉、删得净,才谈得上说得清
先看"关掉开关"为什么这么难。只要数据必须以明文进入模型,掌握算力的一方就必然能读到原文。这是架构层的结果,跟哪家公司道德水平高低无关。平台的隐私政策和安全承诺,画的是平台自己的免责底线,不是用户数据的护城河。
再看"已删除"的数据拿什么证明。数据一旦上云,"删了"就成了平台单方面的说法。密钥在谁手上、删除日志谁能看、访问记录留不留下,用户不知道。这也是此类争议里最难回答的一问:不是有没有传,而是传了以后怎么收场。
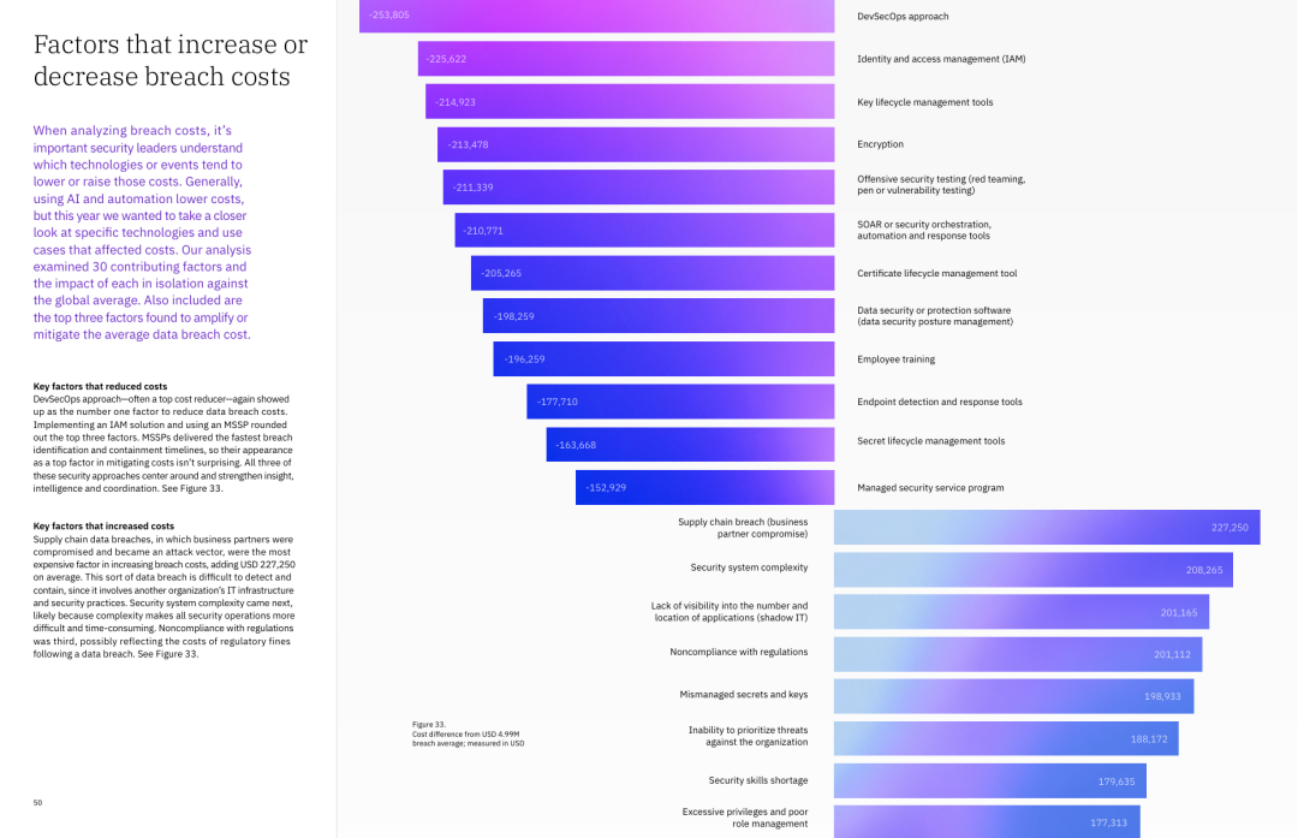
IBM《2026 年数据泄露成本报告》给出的数字是全球平均 499 万美元,创历史新高。对企业来说,一次边界失控的代价,远比换一套工具贵得多。
真正能把这道题封死的,是让上传出去的数据本身就读不懂。
看不见原文,也能照样算
原理其实并不复杂,落到工程上它构建了一条贯穿始终的密态数据流:数据在离开本地设备前即被加锁锁定为密文,私钥始终掌握在用户自己手里;数据进入云端后,传输、存储以及模型推理全流程均保持密态运行;直至计算结果原路返回本地设备,才凭私钥解密还原为明文。
在这条端到端的闭环链路中,服务器管理员看到的始终是一堆无序乱码,即便数据在半路被截获或拖走,拿到的也只是一堆无法解读的废料。
"不管任何人想窃取你的数据,拿到的都只是密文。"荆华密算创始人、CEO 林修醇说。
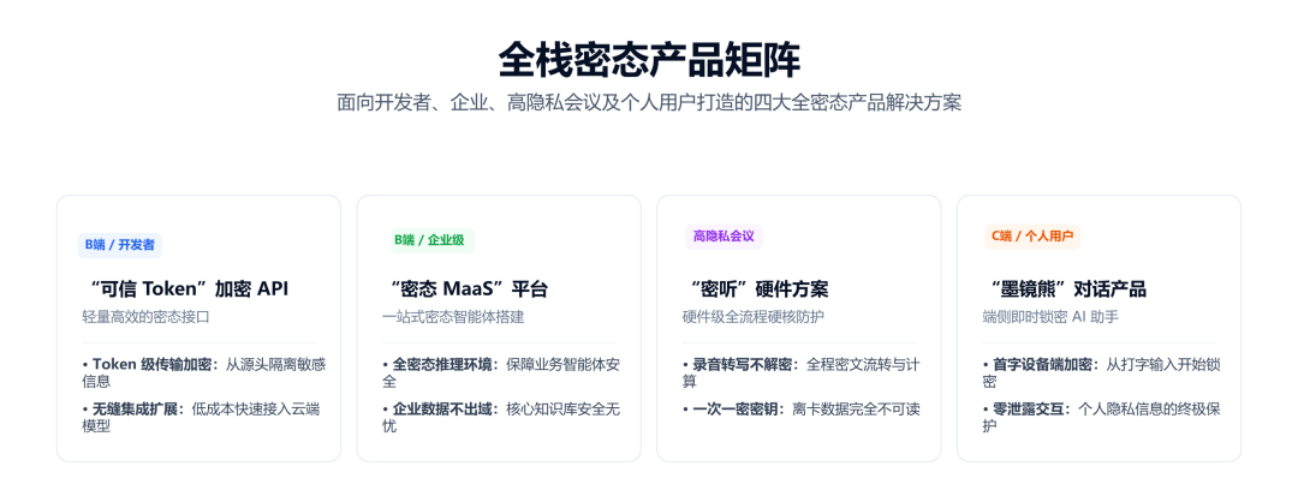
目前,这套能力已成功落地于「可信 Token」、「密态 MaaS」、「墨镜熊」和「密听」四款产品,实现了涵盖企业、开发者、个人及会议场景的数据全流程「可用不可见」加密防护。
用密码学做 AI 推理并不新鲜,十几年前就有论文,真正的死穴是慢,用户的体感就是严重卡顿。荆华密算就是把这种损耗从明文的万倍降至可商用水平,同时保证业务精度与明文一致。跨过这道坎,安全才不只停留在演示阶段。
技术之外还有一层制度兜底。荆华密算与中国人民保险签下全球首个人工智能数据安全保险,平台数据一旦泄露,保险公司按约理赔。道德承诺可以改,白纸黑字的合同不好改。
只有把边界写进架构才敢用AI
这类争议最直接的影响,是倒逼企业采购标准的改变。
过去挑选 AI 工具,核心指标是模型能力、生成速度与功能丰富度;而如今,数据安全与可控性已跃居首位,由过去的「加分项」演变为现在的「硬门槛」。这种转变,让专注于安全底座的厂商迎来了新机遇——AI 的落地不再依赖于用户对平台的口头承诺或盲目信任。
林修醇认为,当前行业竞争的焦灼点,正是能否消除用户将真实商业项目放入对话框的顾虑。为此,荆华密算推出了全链路密算方案,做到「问题在终端上锁,答案回到终端解密,中间传输与计算全过程不可见」,真正打通了「数据敢流动、AI 敢使用」的最后一公里。
来源:互联网