面壁智能在 MiniCPM-V 4.7 技术交流会上介绍,旗舰版 350 亿参数模型借助混合专家架构和前瞻专家调度,在 iPhone 17 Pro Max 上只占约 3GB 内存,生成速度超过每秒 13 个 token。
11 月 5 日,面壁智能在北京举行 MiniCPM-V 4.7 技术交流会,介绍了这款多模态模型在手机上的运行方式。按面壁公布的测试结果,旗舰版有 350 亿个参数,在 iPhone 17 Pro Max 上占用约 3GB 运行内存,生成速度达到每秒 13 个 token 以上。
MiniCPM-V 4.7 由面壁智能和 OpenBMB 社区于 10 月 13 日发布并开源,能处理图片、文档和视频。此次更新提供两个版本:旗舰版 35B-A3B 尝试提高手机能运行的模型能力上限,另一个 10 亿参数的版本则面向入门级设备。面壁智能联席首席科学家姚远在会上回顾,早期 MiniCPM 模型只有一二十亿个参数。随着硬件和推理效率提高,团队希望把手机多出来的算力用在更强的模型上。
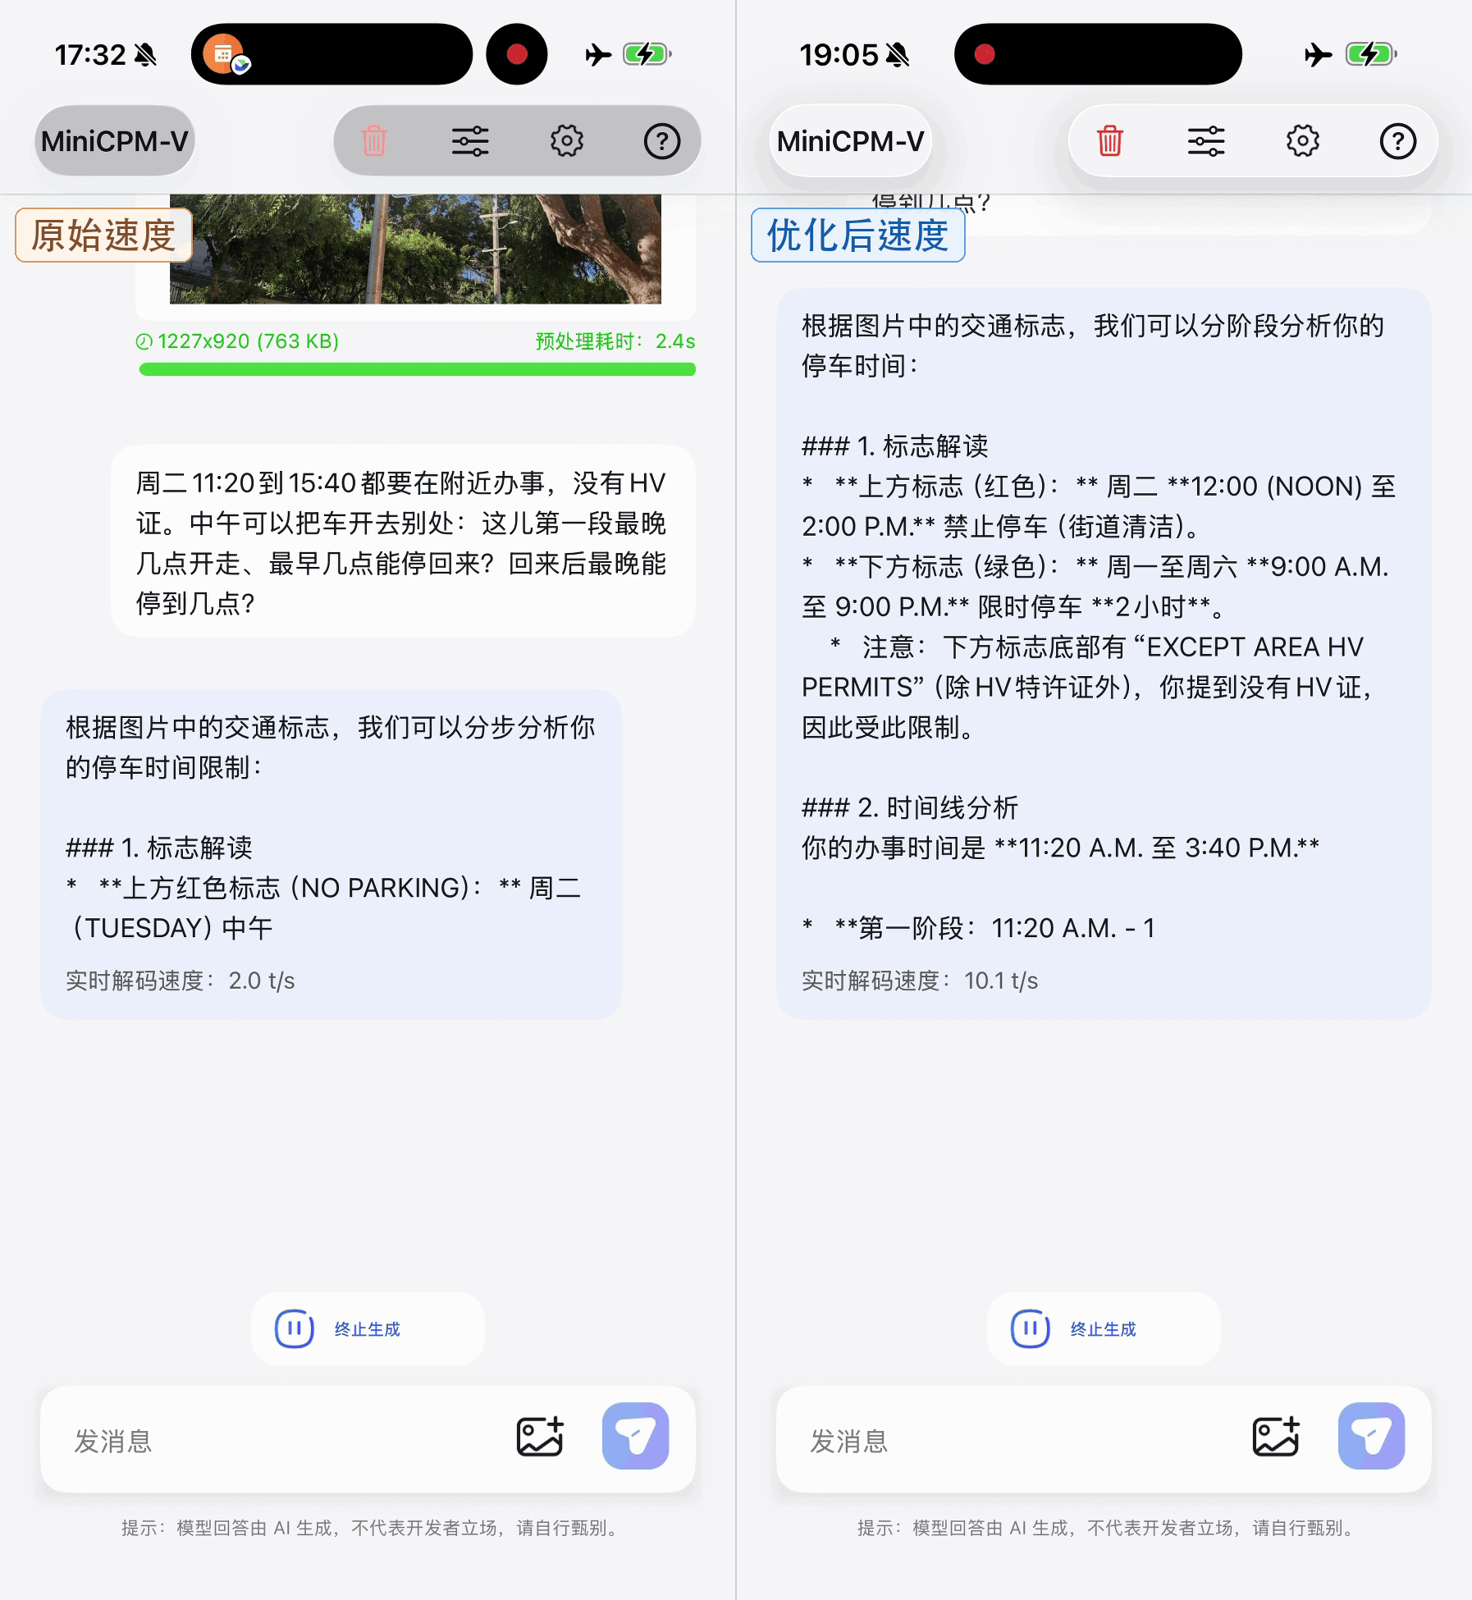
手机读图演示,左为原始速度,右为优化后速度(录屏截帧)|图片来源:OpenBMB
把专家提前读进内存
350 亿个参数和约 3GB 内存,说的是两件不同的事。面壁给出的数字是,旗舰版的完整权重约为 65.6 GiB。要在手机上运行它,首先得解决一个问题:有多少参数必须同时放在内存里?
35B-A3B 采用混合专家架构。模型内部有许多叫做「专家」的计算模块,每生成一个 token,也就是一小段文本,只会动用其中一部分,总共激活约 30 亿个参数。大部分专家因此可以放在手机的闪存中,用到谁,就把谁读进内存。约 3GB 是运行时的内存占用,手机上仍然需要给模型文件留出存储空间。
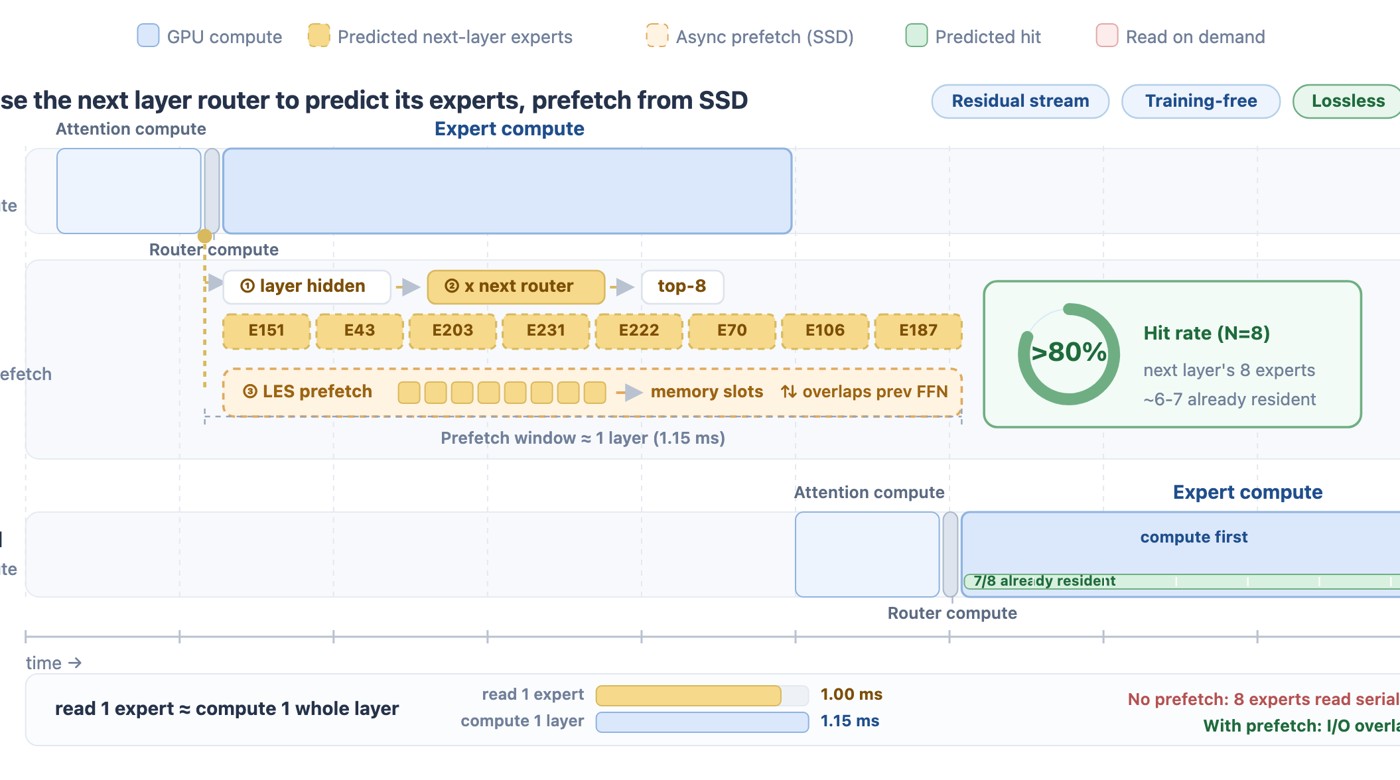
问题在于,模型通常要等上一层算完,才知道下一层需要哪些专家。如果到了这一步才开始读闪存,芯片就会花很多时间等数据。面壁采用了「前瞻专家调度」:这一层还在计算时,先预测下一层会用谁,让手机在后台提前读取。按团队测试,在多数场景下,超过八成所需专家可以提前就位。预判遗漏的专家也会照常加载,预判影响的是等待时间,最终参与计算的模块仍由模型自己选定。
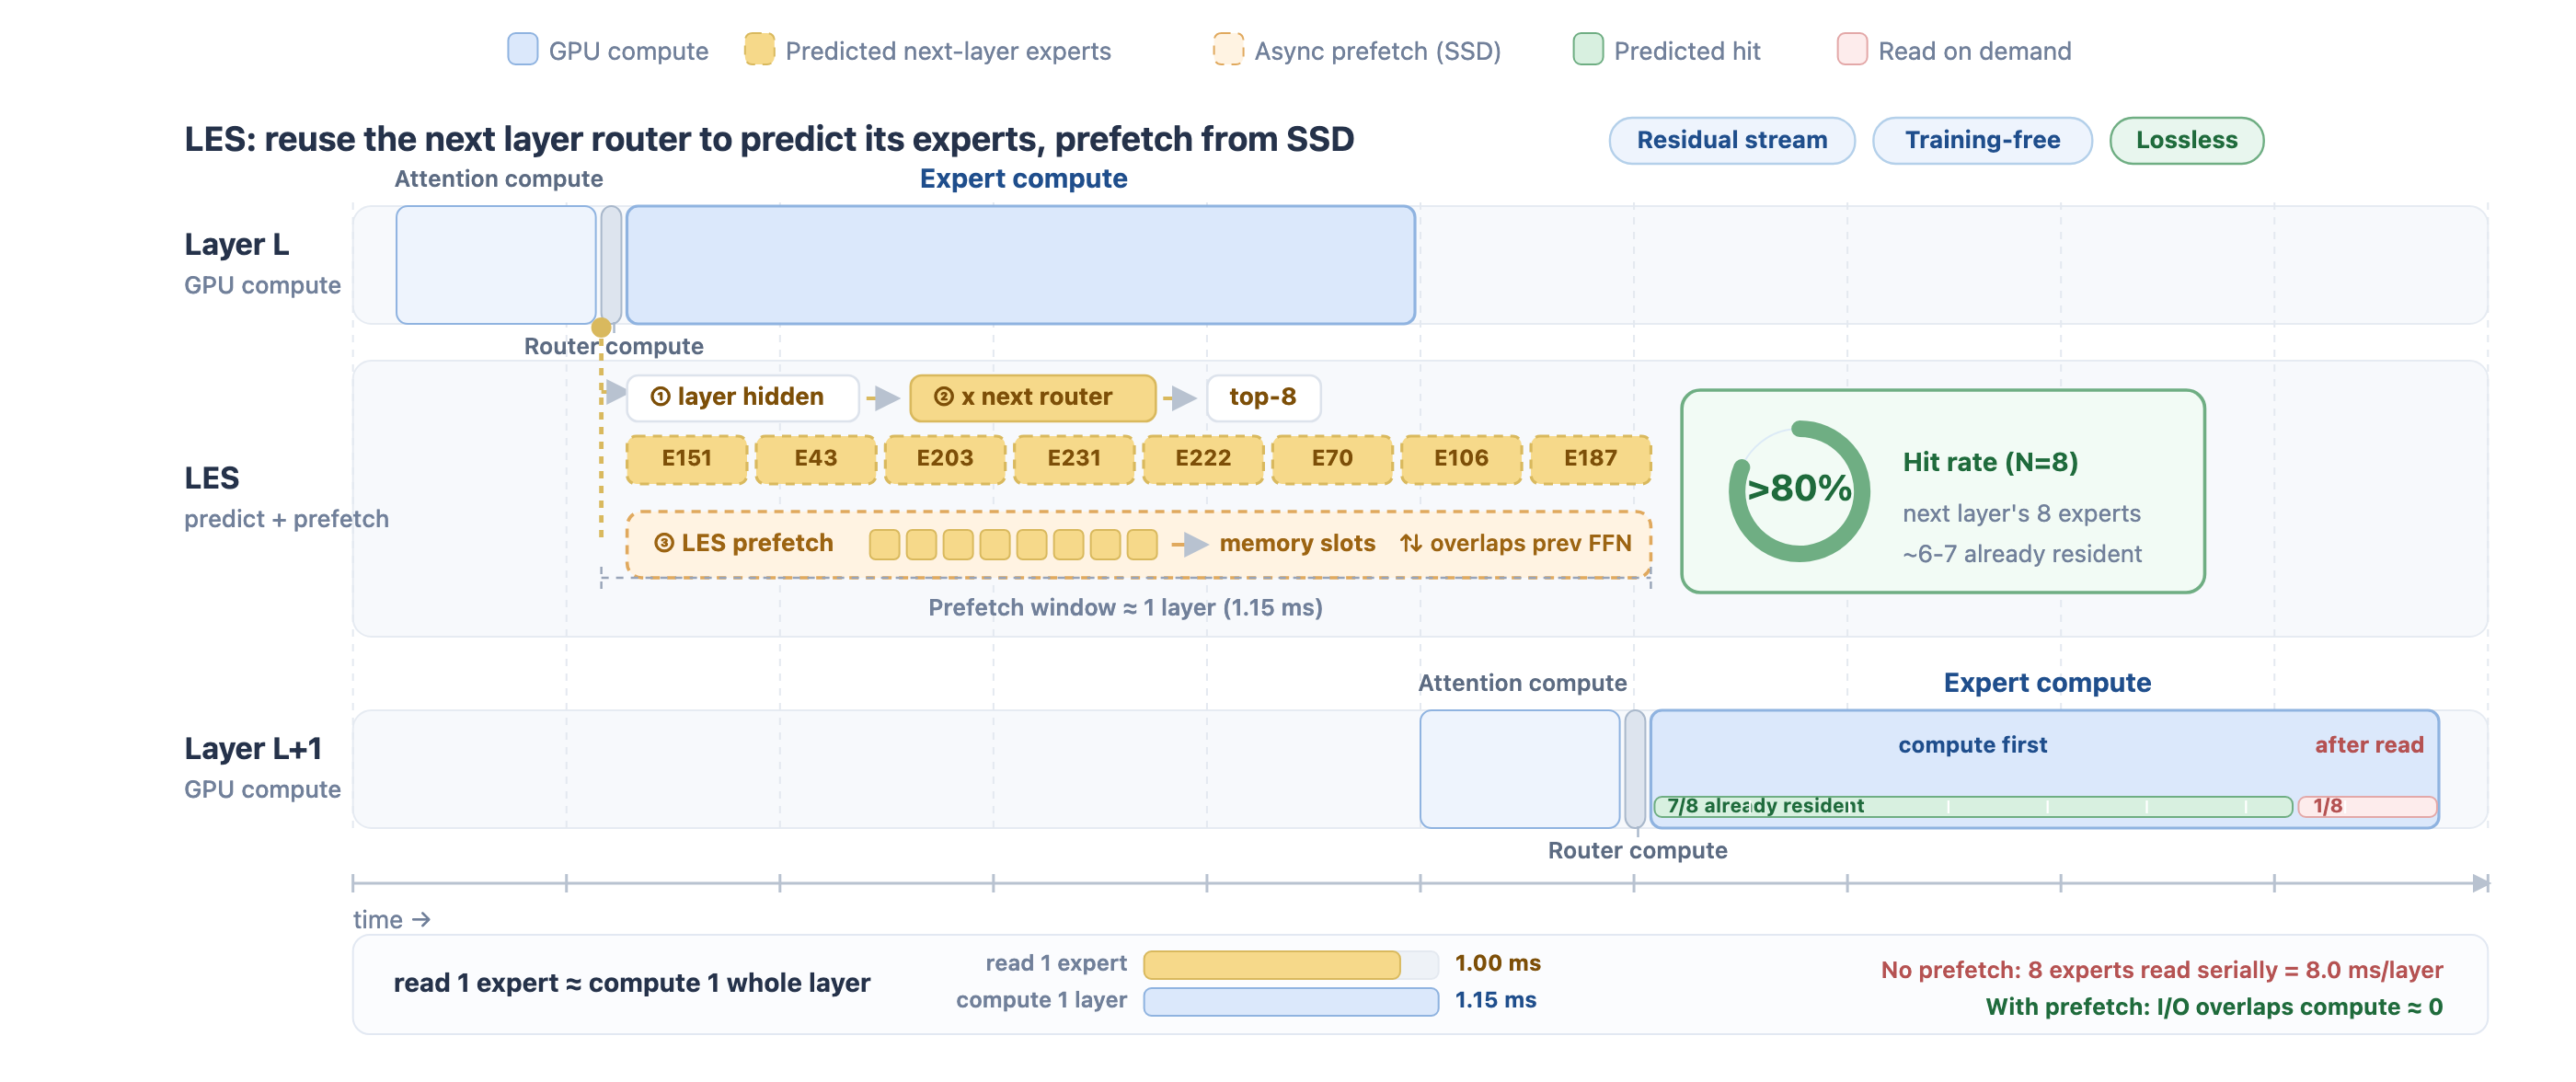
提前读取下一层可能用到的专家,减少等待时间|图片来源:OpenBMB
团队还把同一专家的参数放在连续的存储位置,方便顺序读取,并为模型的不同层选择合适的精度,减少搬运的数据量。按面壁公布的结果,在配备 16GB 内存的 M4 iPad Pro 上,旗舰版的生成速度达到每秒 17 个 token 以上。
手机上的两段等待
极客公园在会后问到,用约 3GB 内存运行这个模型时,速度、功耗和回答质量该如何取舍?面壁智能多模态大模型实验室算法研究员蔡天驰给了一个与阅读速度有关的答案:在团队看来,对着手机屏幕看一段回答,每秒输出约 15 个 token 就已经比较流畅。内部测试中,更小的模型可以跑得更快,但文字滚动太快,人也来不及看。团队更愿意在接近这个速度时,把设备资源用在提高回答质量上。
不过,出字只是用户等待的一部分。拍一页文档发给模型,在第一个字出现之前,手机得先把图里的小字看清楚。姚远说,现场样机处理图片时,可能仍要等约两秒。对用户而言,这两秒和随后文字出现的快慢,是两种很容易分辨的体验。
为减少读图的开销,V 4.7 沿用了上一代在视觉编码阶段提前压缩信息的做法,并提供两档压缩率。处理文字密集的文档时,可以选择 4 倍压缩,多留些细节;对响应更敏感的场景,可以选择 16 倍压缩,减少后续计算。按面壁公布的评测,旗舰版在指令模式下,相比同样采用混合专家架构的 Qwen3.6-35B-A3B,以更短的推理时间取得了更高的综合得分。
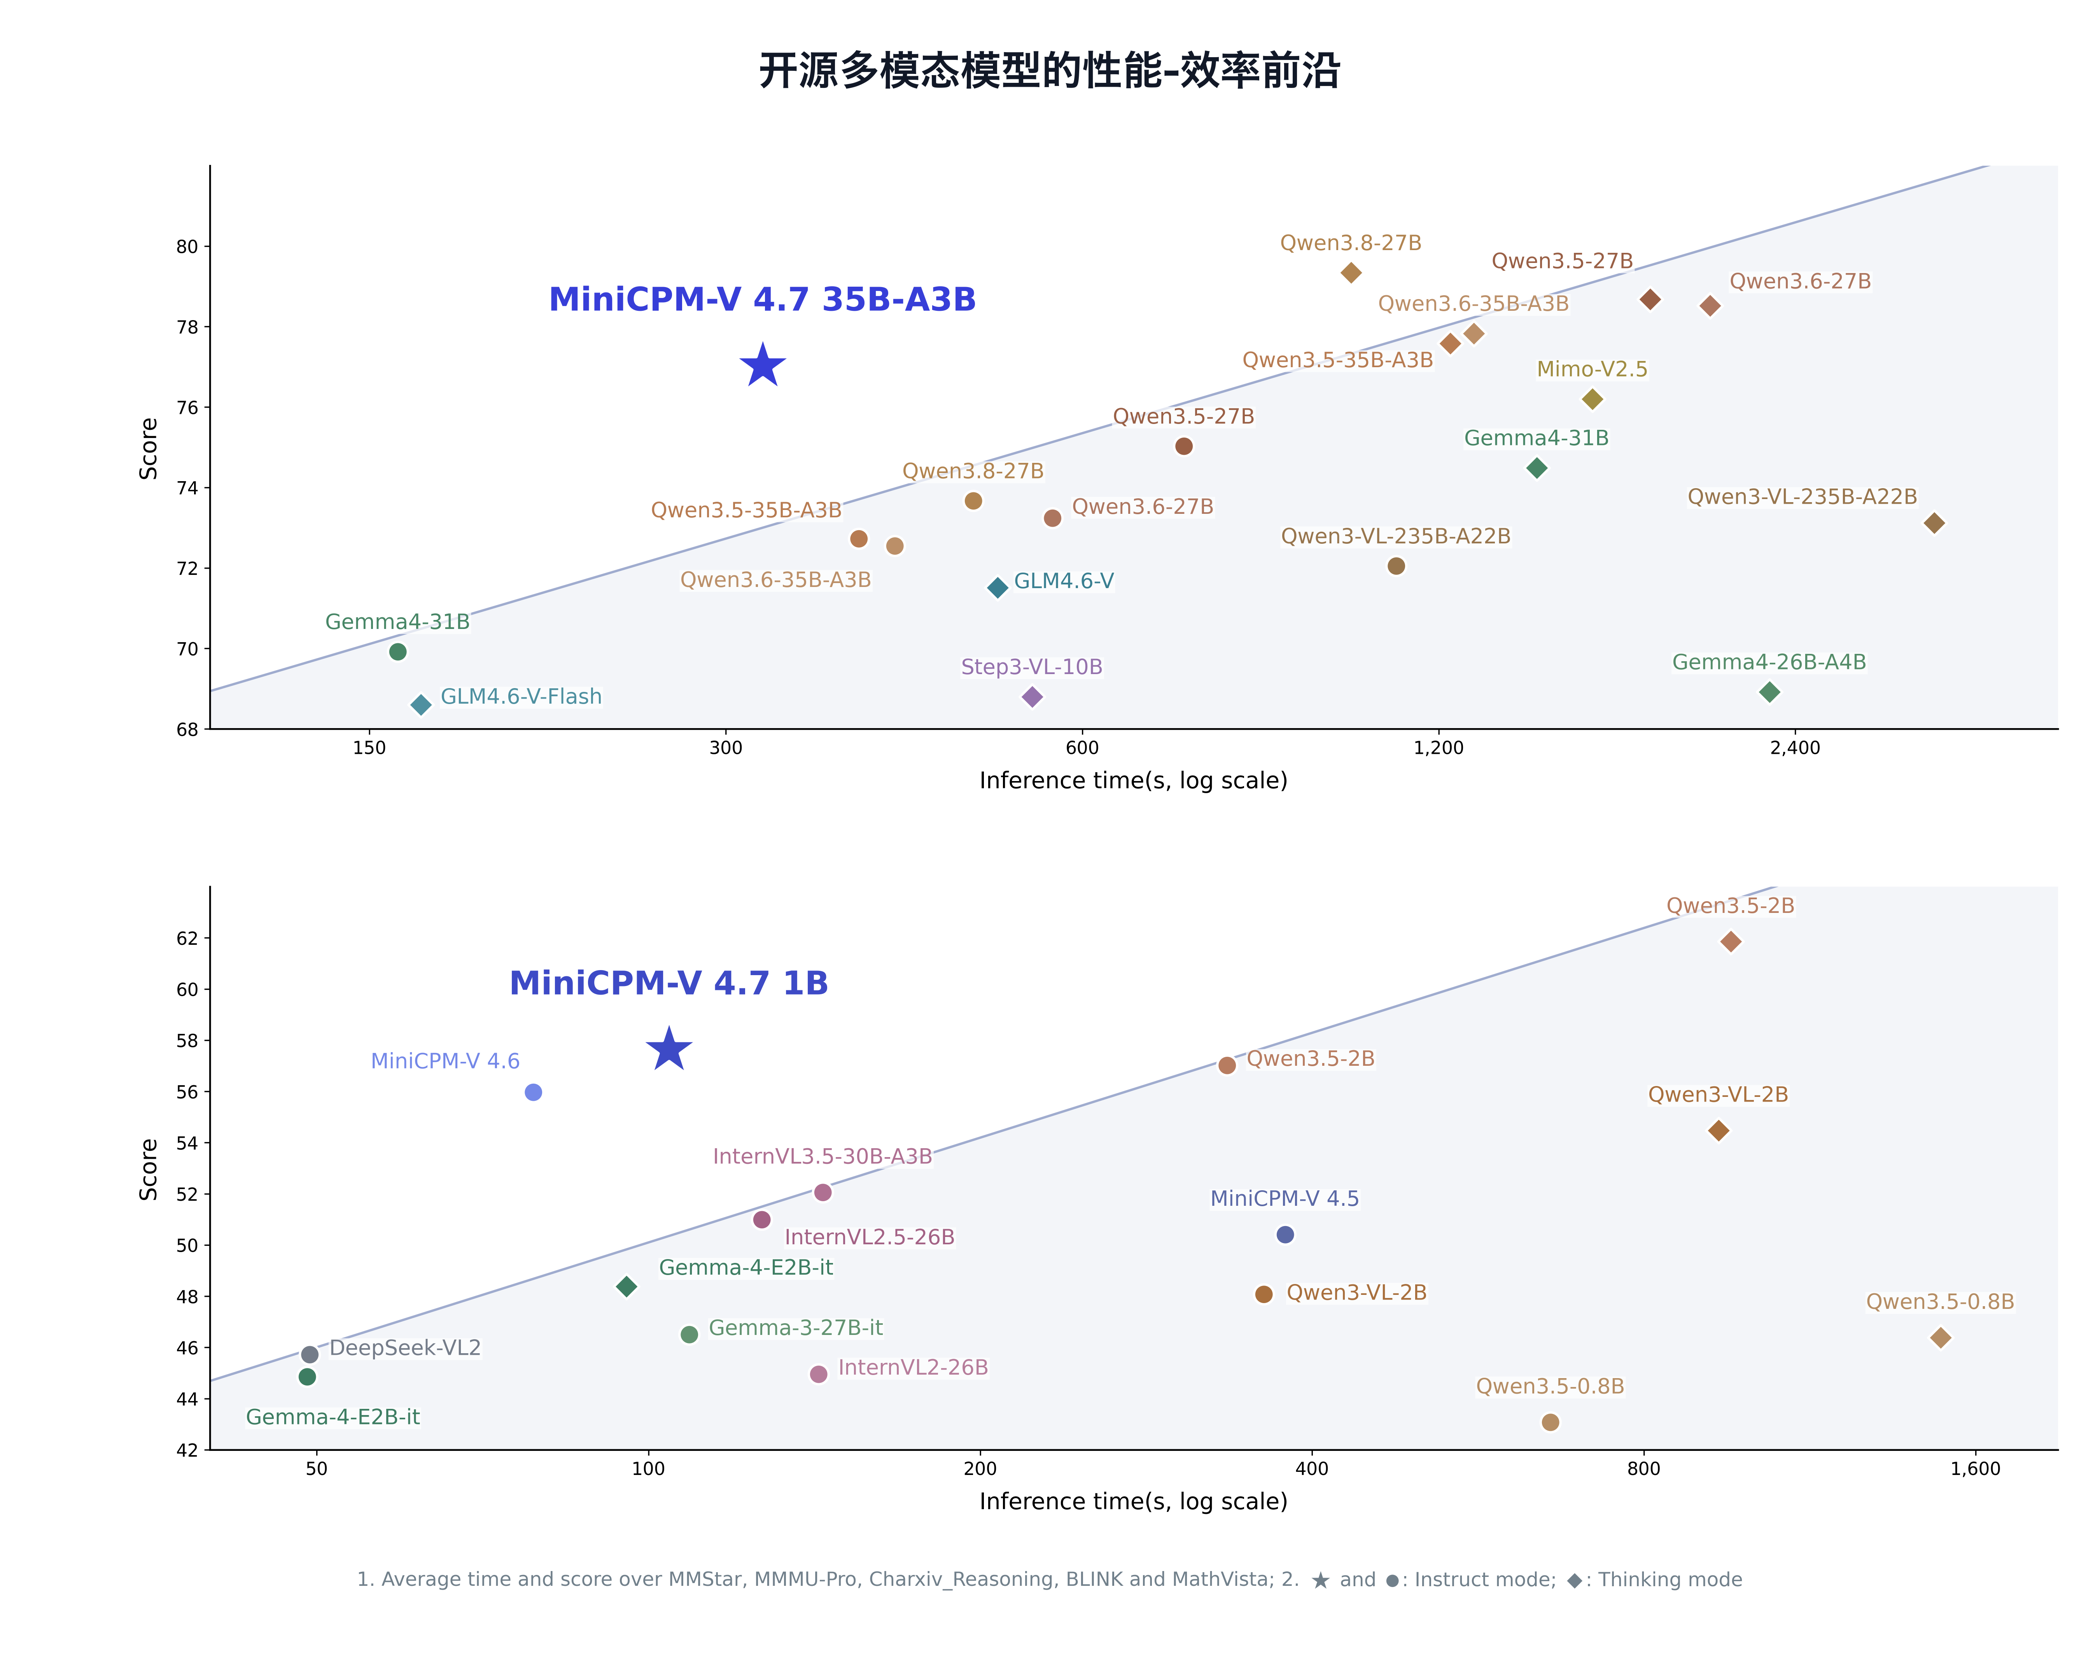
两款模型的评测得分与推理时间(官方测试)|图片来源:OpenBMB
从看一张图到随时待命
手机上的哪些功能值得优先放到本地?面壁在与手机厂商的交流中听到过一个很朴素的需求:把通话语音留在手机上转写。一通电话可能谈到家事,也可能涉及公司的保密信息。即便联网方便,用户也有理由希望原始录音留在自己手里。
如果再往前走一步,让智能助手从日常录音和画面中积累个人记忆,光把内容存下来还不够。极客公园在现场问,端侧模型怎样避免记错、理解错?同一实验室的算法研究员余天予认为,证件信息、重要纪念照等应保留原件。手机上的交互更频繁,模型也有机会从用户的反馈里修正理解。至于助手如何察觉自己理解有误、回到原始记录核对,团队在这次交流中没有披露具体做法。
要让这样的助手长时间在线,还有一个更直接的约束:电量。「以当前版本为例,运行模型时的功耗大致与运行一款大型手游相当。」蔡天驰说。团队希望通过优化计算方式、配合芯片特性,把功耗降到接近长时间听歌的水平,并认为在这一代芯片上仍有优化空间。会上,面壁没有给出连续运行数小时的整机耗电数据。
姚远认为,实际产品会采用端云协同:持续产生的声音、图像等信息优先在本地处理,设备难以完成的复杂推理再交给云端。具体到手机,第三方模型能拿到哪些数据、能替用户操作哪些应用,也取决于手机厂商开放的系统权限。
截至 11 月 5 日,面壁称,此前版本的模型已进入量产机型,V 4.7 正由多家厂商测试。团队也在自行购买的设备上做了适配。目前,模型权重、推理代码及微调代码均已开源,开发者可以自行部署。普通用户能在哪款手机的哪个内置功能里用上 V 4.7,还要看终端厂商的产品安排。