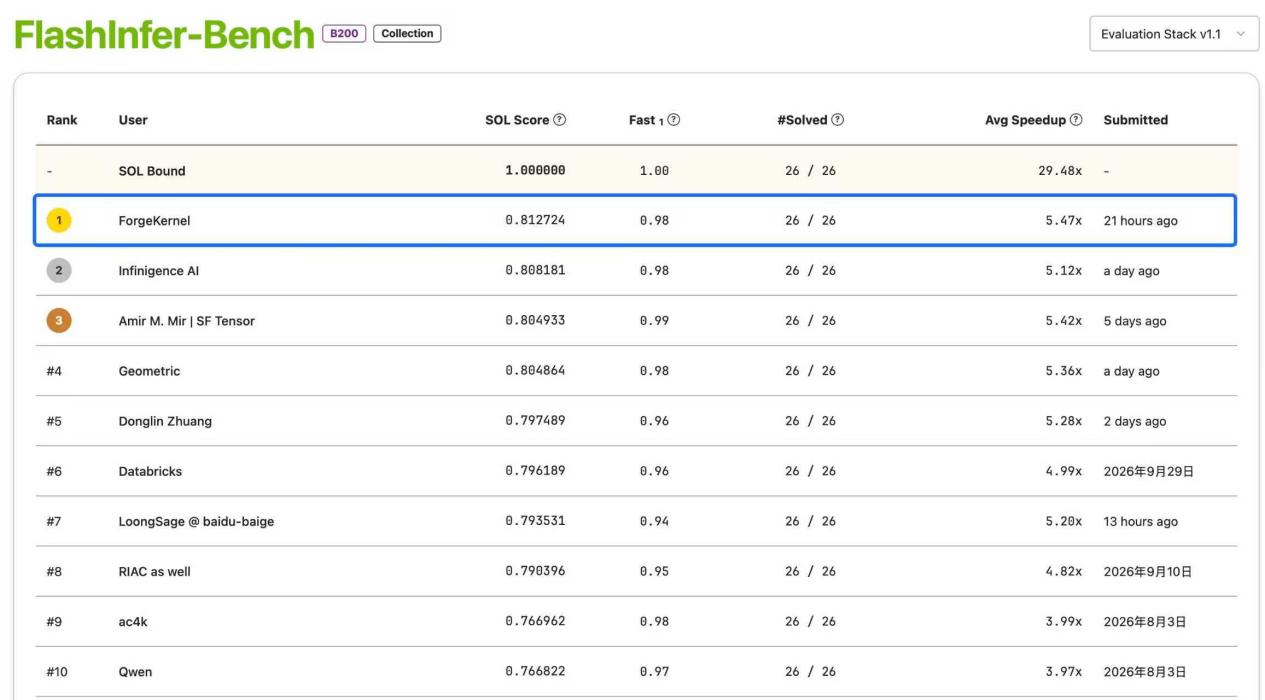
国产大模型竞争延伸至算力层,算子效率决定显卡性能与 token 成本。DeepSeek 近日开源推理框架 DeepInfer 及 FlashMLA、DeepGEMM 等算子库,手调算子达硬件极限 90% 以上。同一周,完全由 AI 编写、无人工调优的 ForgeKernel 同时登顶英伟达与昇腾两个算子评测榜,基准加速比 1.835×,领先第二名 25%。
从模型层到算力层:算子效率决定每个 token 的价格
核心结论:国产大模型的竞争正从模型层延伸到算力层——再强的模型,最终都要以算子的形式在芯片上执行。同一个模型、同一块芯片,换一套更优的算子,有时会带来数倍的性能提升。换句话说,算子的效率既决定同样的显卡能跑多快,也决定每个 token 的价格。
DeepSeek 近日全面开源推理框架 DeepInfer:继模型权重和 FlashMLA、DeepGEMM 等算子库之后,他们把模型运行的链路也开放了出来。其中 FlashMLA 存在工程师在芯片上逐行手调的版本,其算子性能达到硬件极限的 90% 以上,这也是目前人类手工调优在部分芯片上达到的极限成绩。
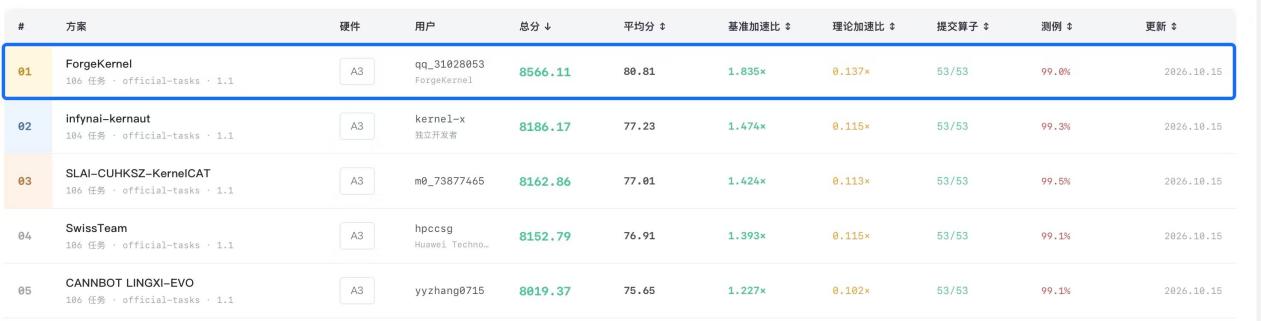
在名次之外,AI 自主优化算子的能力同样不容小觑:在 DeepSeek v4.1 Flash 的算子上,相比 DeepSeek 开源的英伟达版本,ForgeKernel 通过从 0 开始用 AI 迭代的方式实现了性能超越。
这是智能进化的接力。无论是 DeepSeek 的开源精神,还是算子优化榜单上焦灼的竞争,最终都导向同一个方向:让国产智能在每一块芯片上都跑得更快。
补充问答
什么是从模型层到算力层:算子效率决定每个 token 的价格?
核心结论:国产大模型的竞争正从模型层延伸到算力层——再强的模型,最终都要以算子的形式在芯片上执行。同一个模型、同一块芯片,换一套更优的算子,有时会带来数倍的性能提升。换句话说,算子的效率既决定同样的显卡能跑多快,也决定每个 token 的价格。
这篇文章的核心结论是什么?
核心结论:国产大模型的竞争正从模型层延伸到算力层——再强的模型,最终都要以算子的形式在芯片上执行。同一个模型、同一块芯片,换一套更优的算子,有时会带来数倍的性能提升。换句话说,算子的效率既决定同样的显卡能跑多快,也决定每个 token 的价格。
还有哪些关键要点?
DeepSeek 近日全面开源推理框架 DeepInfer:继模型权重和 FlashMLA、DeepGEMM 等算子库之后,他们把模型运行的链路也开放了出来。其中 FlashMLA 存在工程师在芯片上逐行手调的版本,其算子性能达到硬件极限的 90% 以上,这也是目前人类手工调优在部分芯片上达到的极限成绩。